

The Greatest Contradiction in the Modern GPU Market
PC-maskinvaremarkedet har vært vitne til et av vår tids mest påfallende arkitektoniske paradokser: Mens inngangsnivåmodellen ble levert med en romslig -buffer, ble betydelig raskere og dyrere grafikkort som , og strengt begrenset til bare . Selv flaggskipet i 4K-klassen, , ble begrenset til kun . Samtidig gikk AMD til motangrep ved å utstyre med 12 GB og fastsette en kompromissløs . Dette var verken en teknisk feil eller en feilberegning i leveringskjeden: NVIDIA forutså den eksplosive veksten i lokalt AI-beregningsbehov og minnekravene til moderne spillmotorer, og begrenset med vilje minnet i forbrukersilikon for å beskytte marginene i bedriftsmarkedet og fremme planlagt foreldelse.
1. Omvendt hierarki: Da mer penger ga deg mindre VRAM
Innenfor standard segmentering av GPU-produkter øker både den rå beregningskraften og minnekapasiteten proporsjonalt i de høyere klassene. Med Ampere presenterte NVIDIA imidlertid spillere for et omvendt hierarki som brøt med konvensjonell maskinvareløkk:
12 GB
GA106-silikon | 192-bits buss. Til tross for budsjettposisjoneringen fikk den den bredeste minnebufferen i mellomklasseutvalget.

8 GB
GA104-silikon | 256-bit-buss. Imponerende beregningsevne begrenset av et utilgivelig bufferloft på 8 GB.
10 GB
GA102-silikon | 320-bit-buss. Markedsført som en førsteklasses 4K-ytelsesgigant, men begrenset av bare 10 GB GDDR6X.
16 GB
Navi 21-silikon | 256-bits + 128 MB Infinity Cache. AMD har fastsatt 16 GB som det ufravikelige målestokken.
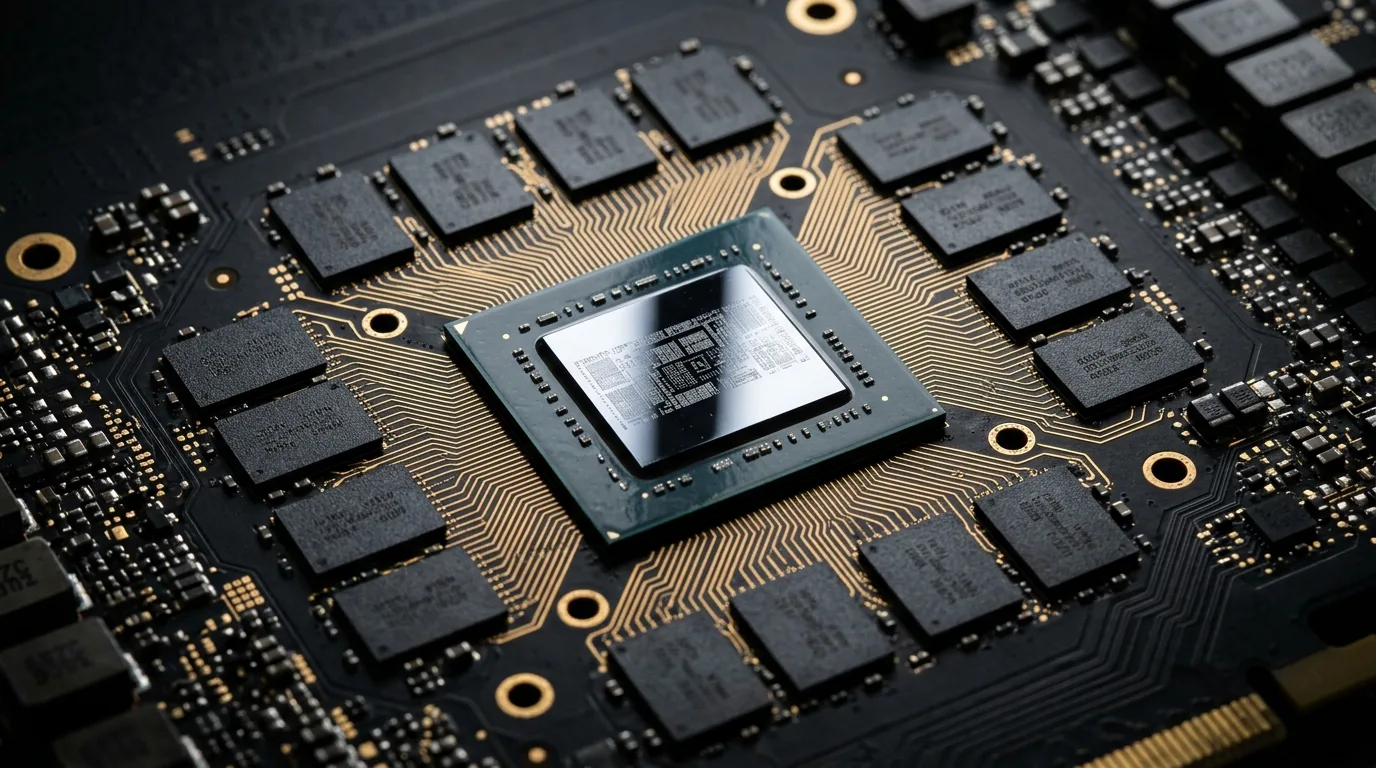
2. 192-bitt-fellen: Hvorfor 3060 fikk 12 GB med makt
Utenforstående betraktet ofte RTX 3060-modellens tildeling på 12 GB som et tegn på korporativ gavmildhet. I virkeligheten var det et uunngåelig teknisk krav, drevet av beregningene knyttet til minnebussen:
- Den 192-bits fysiske begrensningen:
- Den kommersielle selvmordet på 6 GB:buffer på 6 GB
- NVIDIAs motvillige hånd:12 GB buffer
Den røykende pistolen: Hvorfor fikk arbeidsstasjonen RTX A4000 16 GB?
Hvis NVIDIA kunne gi 12 GB til budsjettklassen, hvorfor fikk da den langt mer kraftige RTX 3070 ikke 16 GB? GA104-brikken har en fullverdig (åtte 32-bit-kanaler). Det ville ha vært enkelt å fylle den med åtte 2 GB-pakker for å oppnå 16 GB.
3. Beskytt bedriftsmarginene mot den lokale KI-revolusjonen
Her ligger kjernebedriftsstrategien. NVIDIA er ikke lenger bare en leverandør av spillhardware; selskapet er den dominerende portvokteren for den globale infrastrukturen for kunstig intelligens. Margene fra virksomhetskunder på datasenterakseleratorer (A100, H100, L40S) overgår fortjenesten fra forbruker-PC-er med en faktor på ti.
Når du kjører open-weight store språkmodeller (Meta Llama 3 8B, Qwen 2.5, DeepSeek) eller diffusjonsmodeller (Stable Diffusion, Flux) lokalt via Ollama, LM Studio eller ComfyUI, gjelder følgende grunnleggende ytelsesregel:
- Parametertilhørigheten til 8B:8,5 til 9,5 GB VRAM
- Kollapsen til RTX 3070 (8 GB):
CUDA Out of Memory - RTX 3060 (12 GB) triumferer:
4. Planlagt foreldelse i spill: 8 GB-stuttergrensen
I AAA-spill lansert etter 2023, som bygger på DirectX 12 Ultimate og Unreal Engine 5, brukes VRAM ikke lenger utelukkende til rå teksturkart. Minnebufferen blir presset av tre ressurskrevende prosesser:
Praktisk 1440p / 4K VRAM-allokering i moderne spillmotorer:
2.0 – 2.5 GB
1.2 – 1.5 GB
7.0 – 8.5 GB
10.2 – 12.5 GB
I krevende utgivelser som , og opplevde eiere av RTX 3070 alvorlig ytelsesforringelse, til tross for at de hadde rikelig med beregningskraft fra grafikkortet:
- Katastrofale 1 % laveste verdier:
- Forringelse av teksturkvalitet:
- RX 6800 Vindication:16 GB Radeon RX 6800
5. Arkitektonisk målestokk: Ampere vs. RDNA 2 – levetid
Den følgende tekniske matrisen beskriver minnebussarkitekturer, lokal AI-kapasitet og stabilitet ved moderne spilling for Ampere- og RDNA 2-produktlinjene:
| GPU-modell | Silisium og buss | VRAM-pool | Status for lokal LLM (8B) | 1440p-spillingens levetid |
|---|---|---|---|---|
| GeForce RTX 3060 | GA106 | 192-bits | 12 GB | Fluent (38 t/s): | Ingen teksturforurensing. Lavere rå FPS, men helt stabil bildefrekvens. |
| GeForce RTX 3060 Ti | GA104 | 256-bits | 8 GB | Chokes: | Alvorlig VRAM-overskridelse og mikro-stuttering i moderne spill. |
| GeForce RTX 3070 / Ti | GA104 | 256-biters | 8 GB | CUDA OOM: | Sterk silikon svekket av teksturpop-in og 1 % lave fall. |
| GeForce RTX 3080 | GA102 | 320-bit | 10 GB | Borderline: | Presterer dårlig ved 4K-strålesporing; hyppige ut-av-minnet-varsel. |
| GeForce RTX 3080 Ti | GA102 | 384-bits | 12 GB | Understøttet: | Tilstrekkelig sikkerhetsmargin ved krevende 1440p/4K-forinnstillinger. |
| Radeon RX 6700 XT | Navi 22 | 192-bits | 12 GB | Solid ROCm-støtte; 8B-modeller lastes uten minnetrykk. | Immun mot teksturbegrensninger ved 1440p-spilling med høy oppdateringsfrekvens. |
| Radeon RX 6800 / XT | Navi 21 | 256-bits | 16 GB | Enestående: | Feilfri: |
6. Konklusjon: Den største ironien i moderne GPU-historie
GeForce RTX 3060 12 GB har befestet arven sin som kortet som ble udødelig ved et uhell. NVIDIA hadde aldri til hensikt å levere en budsjettvennlig AI-favoritt eller en aldringssikker mester; matematikken bak en 192-bit-buss ga dem rett og slett intet levedyktig alternativ til 12 GB.
Derimot har den kalkulerte beslutningen om å sperre RTX 3070 og 3070 Ti inn i en 8 GB-sandkasse ført til at førsteklasses silikon har blitt tidlig foreldet i både moderne spilmotorer og lokale KI-arbeidsflyter. Ampere-generasjonen er en varig lærepenge for PC-byggere: Rå kjernetal og beregningsfrekvenser er meningsløse når en underforsynt minnebuffer hindrer silikonet i å få puste.
Ofte stilte spørsmål
Holdt RTX 3060 12 GB virkelig lenger enn RTX 3070 8 GB?
Ved ren rasterisering, der VRAM ikke er mettet, er 3070 fortsatt raskere. I moderne spill der VRAM overstiger 8 GB, opplever 3070 imidlertid alvorlig mikro-stuttering og utydelige teksturer, mens 3060 opprettholder stabil bildefrekvens. I lokale AI-arbeidsflyter (Ollama/LLM-er) overgår 3060 med 12 GB 3070 fullstendig.
Hvorfor utstynte ikke NVIDIA RTX 3070 med 16 GB?
Det fantes ingen tekniske barrierer. Den profesjonelle arbeidsstasjonen RTX A4000 brukte nøyaktig samme GA104-GPU-brikke med hele 16 GB minne. NVIDIA holdt med vilje 3070-modellen på 8 GB for å beskytte salget av 10 GB RTX 3080 og forhindre at billige forbrukeroppsett med flere GPU-er skulle konkurrere med deres lønnsomme KI-akseleratorer for bedriftsmarkedet.
Hvorfor er 8 GB VRAM utilstrekkelig for lokale AI-språkmodeller?
En standard 8B-parametermodell med 4-bits kvantisering tar opp rundt 5 GB, men aktivering av et kontekstvindue på 8k tokens øker det totale behovet til 8,5–10 GB. Når minnet flyter over til system-RAM, reduserer høy PCIe-latens genereringshastigheten fra 40 tokens per sekund til bare 1 token per sekund.
Hvorfor fører uttømming av VRAM til voldsom hakking i stedet for bare en moderat reduksjon i FPS?
GDDR6-minne har en båndbredde på 400–500 GB/s, mens hovedkortets PCIe x16-plass har en maksimal båndbredde på 15–30 GB/s. Når GPU-en går tom for lokal VRAM og må hente data over PCIe fra system-RAM, stanser prosessoren mens den venter på ressurser, noe som fører til plutselige spikker på flere millisekunder i bildesendingshastigheten (1 % laveste-verdi-kollaps).
Have thoughts, questions, or benchmarks on this topic? Join the discussion on our forums.
Join Discussion ➔


Bli med i samtalen