

The Greatest Contradiction in the Modern GPU Market
Rynek sprzętu komputerowego stał się świadkiem jednego z najbardziej uderzających paradoksów architektonicznych naszych czasów: podczas gdy podstawowy model był dostarczany z hojnym buforem , znacznie szybsze i droższe karty graficzne, takie jak , i , zostały celowo ograniczone do zaledwie . Nawet flagowy model z segmentu 4K, , otrzymał zaledwie . Tymczasem AMD przeszło do ofensywy, wyposażając w 12 GB i ustalając nieustępliwy . Nie było to ani błędem inżynieryjnym, ani pomyłką w prognozach dostaw: NVIDIA przewidziała gwałtowny wzrost zapotrzebowania na obliczenia AI lokalnie oraz rosnące wymagania pamięciowe nowoczesnych silników gier i celowo ograniczyła zasoby pamięci w układach konsumenckich, aby chronić marże z segmentu korporacyjnego i wywołać planowaną obsolencję.
1. Odwrócona hierarchia: Kiedy płacenie więcej oznaczało mniej pamięci VRAM
W standardowej segmentacji produktów GPU wyższe poziomy oferują proporcjonalnie większą moc obliczeniową i pojemność pamięci. Jednak w przypadku architektury Ampere firma NVIDIA przedstawiła graczom odwróconą hierarchię, która sprzeciwiała się konwencjonalnej logice sprzętowej:
12 GB
Silikon GA106 | 192-bitowa magistrala. Mimo pozycjonowania jako produkt budżetowy, otrzymał najszerszy bufor pamięci w ofercie średniej klasy.

8 GB
Krzem GA104 | 256-bitowa magistrala. Potężna przepustowość obliczeniowa ograniczona przez surowy limit 8 GB pamięci podręcznej.
10 GB
Silikon GA102 | Szyna 320-bitowa. Promowany jako flagowy potwór do obsługi 4K, a jednak ograniczony do zaledwie 10 GB pamięci GDDR6X.
16 GB
Silikon Navi 21 | 256-bitowa szyna + pamięć podręczna Infinity o pojemności 128 MB. AMD ustaliło 16 GB jako nieprzekraczalny standard.
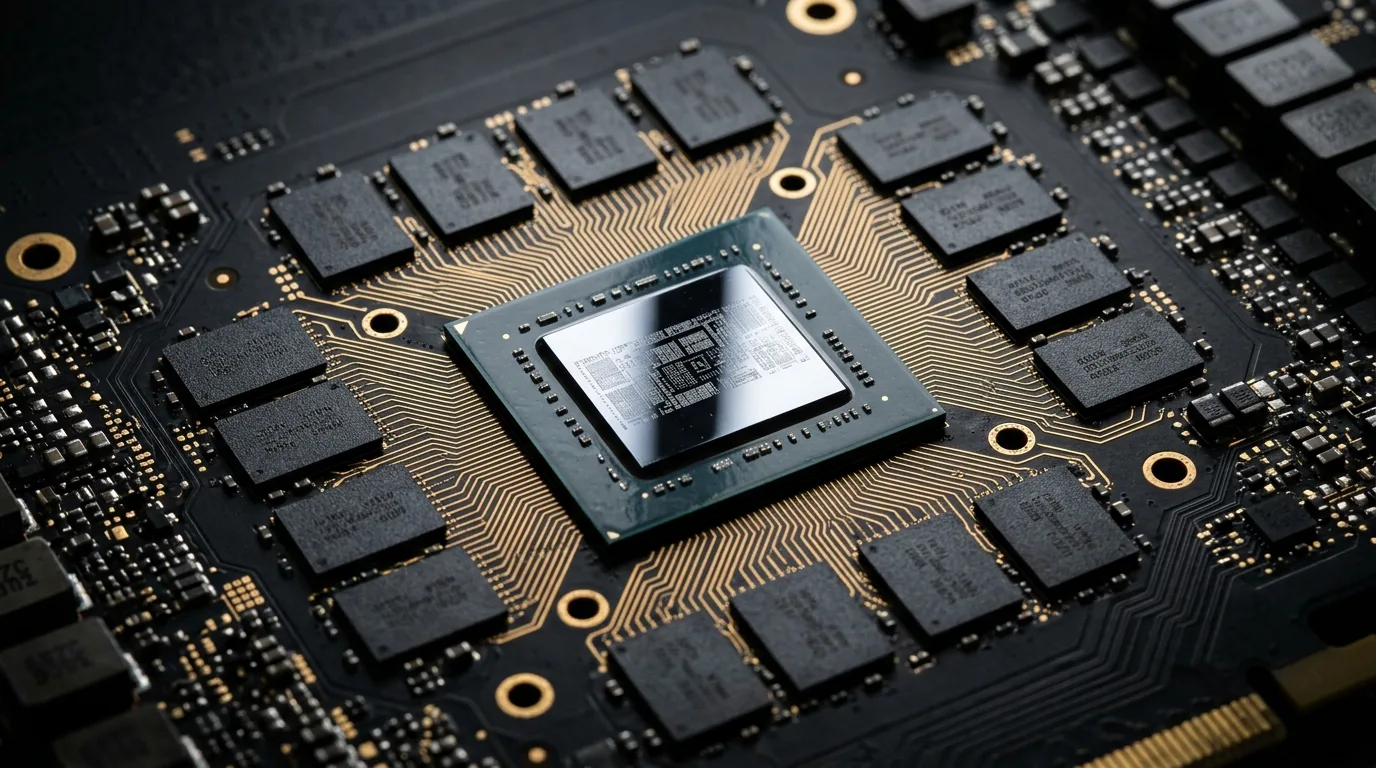
2. Pułapka 192 bitów: Dlaczego 3060 dostała 12 GB siłą
Przypadkowi obserwatorzy często błędnie interpretowali przydział 12 GB pamięci w karcie RTX 3060 jako akt korporacyjnej hojności. W rzeczywistości był to nieunikniony wymóg inżynieryjny, wynikający z matematyki magistrali pamięci:
- 192-bitowe ograniczenie fizyczne:
- Komercyjny samobójczy wariant 6 GB:buforem 6 GB
- Niewolna ręka NVIDII:bufor 12 GB
Dowód palący: Dlaczego karta graficzna do stacji roboczych RTX A4000 otrzymała 16 GB pamięci?
Jeśli NVIDIA mogła zapewnić 12 GB w wersji budżetowej, to dlaczego znacznie wydajniejszemu RTX 3070 odmówiono 16 GB? Układ GA104 posiada pełny (osiem 32-bitowych kanałów). Obsadzenie jej ośmioma pakietami po 2 GB w celu uzyskania 16 GB było banalnie proste.
3. Ochrona marż przedsiębiorstw przed lokalną rewolucją AI
Tutaj leży sedno strategii korporacyjnej. NVIDIA nie jest już jedynie dostawcą sprzętu do gier; stała się dominującym strażnikiem globalnej infrastruktury sztucznej inteligencji. Marże przedsiębiorstw na akceleratorach do centrów danych (A100, H100, L40S) przewyższają zyski z komputerów stacjonarnych dla konsumentów o rząd wielkości.
Podczas lokalnego uruchamiania otwartych modeli językowych dużej skali (Meta Llama 3 8B, Qwen 2.5, DeepSeek) lub modeli dyfuzyjnych (Stable Diffusion, Flux) za pomocą Ollama, LM Studio lub ComfyUI, obowiązuje absolutna zasada wydajności:
- Obraz parametrów 8B:8,5 do 9,5 GB pamięci VRAM
- Krach RTX 3070 (8 GB):
CUDA Out of Memory - Triumf RTX 3060 (12 GB):
4. Planowana przestarzałość w grach: Bariera 8 GB powodująca zacinanie się
W tytułach AAA wydanych po 2023 roku, opartych na DirectX 12 Ultimate i Unreal Engine 5, VRAM nie jest już zużywany wyłącznie przez surowe mapy tekstur. Bufor pamięci jest obciążany przez trzy wymagające zasobów potoki:
Przydział pamięci VRAM dla 1440p / 4K w nowoczesnych silnikach graficznych:
2.0 – 2.5 GB
1.2 – 1.5 GB
7.0 – 8.5 GB
10.2 – 12.5 GB
W wymagających tytułach, takich jak , i , użytkownicy kart RTX 3070 napotkali poważne spadki wydajności, mimo dysponowania wystarczającą mocą obliczeniową GPU:
- Katastrofalne 1% minima:
- Degradacja tekstury:
- RX 6800 Vindication:16 GB Radeon RX 6800
5. Karta oceny architektury: Ampere vs. RDNA 2 – żywotność
Poniższa macierz techniczna przedstawia architektury szyn pamięci, lokalne możliwości AI oraz stabilność w nowoczesnych grach w liniach produktów Ampere i RDNA 2:
| Model GPU | Krzem i magistrala | Pula VRAM | Status lokalnego modelu LLM (8B) | Długowieczność gier w rozdzielczości 1440p |
|---|---|---|---|---|
| GeForce RTX 3060 | GA106 | 192-bitowy | 12 GB | Fluent (38 t/s): | Brak zacierania tekstur. Niższa surowa liczba klatek na sekundę, ale niezwykle stabilne tempo wyświetlania klatek. |
| GeForce RTX 3060 Ti | GA104 | 256-bitowy | 8 GB | Chokes: | Poważne przepełnienie pamięci VRAM i mikrozacinanie w nowoczesnych tytułach. |
| GeForce RTX 3070 / Ti | GA104 | 256-bitowy | 8 GB | CUDA OOM: | Potężny silikon sparaliżowany przez efekt „texture pop-in” oraz 1% niskich spadków wydajności. |
| GeForce RTX 3080 | GA102 | 320-bitowy | 10 GB | Granica: | Trudności z renderowaniem 4K z ray tracingiem; częste ostrzeżenia o braku pamięci. |
| GeForce RTX 3080 Ti | GA102 | 384-bitowy | 12 GB | Obsługiwane: | Wystarczający margines bezpieczeństwa przy wymagających ustawieniach 1440p/4K. |
| Radeon RX 6700 XT | Navi 22 | 192-bitowy | 12 GB | Solidne wsparcie ROCm; modele 8B ładują się bez obciążania pamięci. | Odporność na wąskie gardła związane z teksturami w grach przy rozdzielczości 1440p i wysokiej częstotliwości odświeżania. |
| Radeon RX 6800 / XT | Navi 21 | 256-bitowy | 16 GB | Niezwykłe: | Bez zarzutu: |
6. Wnioski: Największa ironia w historii nowoczesnych kart graficznych
GeForce RTX 3060 12 GB utrwalił swoją pozycję jako karta, która stała się nieśmiertelna przez przypadek. NVIDIA nigdy nie zamierzała stworzyć budżetowego faworyta wśród kart do AI ani niezastarzewalnego mistrza; matematyka 192-bitowej magistrali po prostu nie pozostawiała im żadnej realnej alternatywy dla 12 GB.
Z drugiej strony, kalkulowana decyzja o ograniczeniu kart RTX 3070 i 3070 Ti do 8 GB pamięci doprowadziła do przedwczesnego przestarzałości tej wysokiej jakości technologii w nowoczesnych silnikach gier i lokalnych procesach AI. Generacja Ampere stanowi trwały урок dla twórców komputerów: surowa liczba rdzeni i częstotliwość obliczeniowa nie mają znaczenia, gdy ograniczona pamięć uniemożliwia efektywne działanie układu.
Często zadawane pytania
Czy RTX 3060 12 GB naprawdę wytrzymał dłużej niż RTX 3070 8 GB?
W przypadku surowej rasteryzacji, gdy VRAM nie jest nasycony, 3070 pozostaje szybsza. Jednak w nowoczesnych tytułach, w których zużycie VRAM przekracza 8 GB, 3070 doświadcza poważnych mikrozacinów i rozmazanych tekstur, podczas gdy 3060 utrzymuje stabilną liczbę klatek na sekundę. W lokalnych przepływach pracy z AI (Ollama/LLM) model 3060 z 12 GB VRAM całkowicie przewyższa 3070.
Dlaczego NVIDIA nie wyposażyła RTX 3070 w 16 GB pamięci?
Nie było żadnej bariery technicznej. Profesjonalna stacja robocza RTX A4000 wykorzystywała dokładnie ten sam układ graficzny GA104 z pełnymi 16 GB pamięci. NVIDIA celowo ograniczyła model 3070 do 8 GB pamięci, aby chronić sprzedaż modelu RTX 3080 z 10 GB pamięci oraz zapobiec sytuacji, w której tanie konsumenckie konfiguracje z wieloma kartami graficznymi zagrażałyby ich dochodowym akceleratorom AI dla przedsiębiorstw.
Dlaczego 8 GB pamięci VRAM jest niewystarczające dla lokalnych modeli językowych AI?
Standardowy model oparty na parametrach 8B przy kwantyzacji 4-bitowej zajmuje około 5 GB, jednak aktywacja okna kontekstowego o rozmiarze 8 tys. tokenów zwiększa całkowite zapotrzebowanie do 8,5–10 GB. Gdy pamięć wyczerpie się i zacznie wykorzystywać pamięć RAM systemu, wysoka latencja PCIe drastycznie obniża prędkość generowania z 40 tokenów na sekundę do zaledwie 1 tokena na sekundę.
Dlaczego wyczerpanie VRAM powoduje gwałtowne zacinanie się obrazu, a nie jedynie niewielki spadek liczby klatek na sekundę?
Pamięć GDDR6 działa z przepustowością 400–500 GB/s, podczas gdy gniazdo PCIe x16 na płycie głównej osiąga maksymalnie 15–30 GB/s. Gdy karta graficzna wyczerpie lokalną pamięć VRAM i będzie musiała pobierać dane przez PCIe z pamięci RAM systemu, procesor ulega zablokowaniu w oczekiwaniu na zasoby, co powoduje nagłe, wielomilisekundowe skoki w czasie renderowania klatki (spadek 1% najniższych wartości).
Have thoughts, questions, or benchmarks on this topic? Join the discussion on our forums.
Join Discussion ➔


Dołącz do dyskusji