Fundamentos del Muestreo de Baja Discrepancia: Secuencias de Halton, Conjuntos de Hammersley y su Papel en el Trazado de Rayos
Las secuencias de baja discrepancia son fundamentales en el trazado de rayos, ya que permiten distribuir los puntos de muestreo de manera más uniforme en el espacio, reduciendo los artefactos visuales y mejorando la convergencia de las imágenes generadas. Entre las técnicas más utilizadas se encuentran las secuencias de Halton y los conjuntos de Hammersley, cada una con características propias que las hacen adecuadas para distintos tipos de muestreo.

Las secuencias de Halton generan puntos utilizando una sucesión de números primos como base para cada dimensión, lo que garantiza una cobertura equilibrada del espacio de muestreo. Este enfoque reduce la probabilidad de agrupaciones no deseadas, un problema común en el muestreo aleatorio tradicional. Sin embargo, en dimensiones elevadas, las secuencias de Halton pueden presentar correlaciones no deseadas entre las variables, lo que afecta la calidad del muestreo.
Los conjuntos de Hammersley representan una variante optimizada diseñada específicamente para problemas de baja discrepancia en múltiples dimensiones. A diferencia de las secuencias de Halton, el conjunto de Hammersley combina un valor fijo con una secuencia de baja discrepancia, lo que lo hace especialmente útil en aplicaciones de trazado de rayos donde se requiere un muestreo eficiente en espacios de alta dimensionalidad.
En el contexto del trazado de rayos, estas técnicas de muestreo juegan un papel crucial en la simulación de fenómenos como la iluminación global, la dispersión de la luz y la generación de sombras suaves. Al distribuir los rayos de manera más uniforme, se logra una estimación más precisa de la energía luminosa en cada punto de la escena, lo que se traduce en imágenes más realistas y con menor ruido.
La elección entre secuencias de Halton, conjuntos de Hammersley u otras técnicas depende de las características específicas de la escena y de los requisitos de calidad y rendimiento del renderizado. En la práctica, a menudo se combinan estos métodos con técnicas de cuantización y variación para maximizar la eficiencia del muestreo y minimizar los artefactos visuales en el resultado final.
Introducción a los Métodos de Monte Carlo Cuasirrandom en el Renderizado
Los métodos de Monte Carlo cuasirrandom (QMC, por sus siglas en inglés) representan una familia de técnicas que buscan mejorar la calidad de la estimación numérica en comparación con los métodos de Monte Carlo clásicos. Mientras que los métodos de Monte Carlo tradicionales utilizan muestras verdaderamente aleatorias, los métodos QMC emplean secuencias de puntos distribuidos de manera más uniforme, conocidas como secuencias cuasirrandom o secuencias de baja discrepancia.
La idea fundamental detrás de estos métodos radica en reemplazar la aleatoriedad clásica por una estructura determinista que, a pesar de su naturaleza predecible, conserva propiedades estadísticas deseables. Esto permite lograr una convergencia más rápida en la estimación de integrales, lo cual es especialmente valioso en el ámbito del renderizado por computadora, donde la precisión y la eficiencia son fundamentales.
En el contexto del renderizado, los métodos de Monte Carlo se han convertido en una herramienta esencial para simular fenómenos complejos como la iluminación global, las sombras suaves, la profundidad de campo y la dispersión de la luz en materiales translúcidos. Sin embargo, la convergencia lenta de estos métodos puede dar lugar a ruido visible en las imágenes finales, lo que exige un número elevado de muestras para obtener resultados aceptables.
Los métodos de Monte Carlo cuasirrandom ofrecen una solución prometedora a este problema, ya que permiten reducir significativamente el ruido y mejorar la calidad de la imagen con un menor número de muestras. A lo largo de este documento, exploraremos los fundamentos teóricos, las técnicas de muestreo y las aplicaciones prácticas de estos métodos en el renderizado por computadora.
El path tracing se apoya fundamentalmente en la integración de Monte Carlo para estimar la ecuación de renderizado al promediar evaluaciones estocásticas de la transmisión de luz. La calidad estadística de un path tracer no depende únicamente de cuántas muestras se extraen, sino de el espacio de muestras subyacente. El muestreo uniforme e independiente ingenuo, aunque no sesgado, produce agrupamientos y vacíos que inflan la varianza; los patrones estratificados mejoran la cobertura espacial a costa de los artefactos en los límites entre estratos. La clase de técnicas descritas aquí——ofrece una estrategia complementaria: conjuntos de puntos deterministas diseñados para estar bien distribuidos simultáneamente en cada dimensión del espacio de muestras, en lugar de estarlo únicamente en una o dos dimensiones examinadas individualmente.
El objetivo central compartido por todos estos muestreadores es generar un conjunto de puntos que estén , garantizando que ninguna muestra quede excesivamente cercana a otra y que ninguna región del espacio de muestreo resulte tan amplia como para quedar completamente sin muestrear. Esta propiedad, conocida formalmente como baja discrepancia o alta uniformidad, reduce directamente el error de integración para funciones integrables suaves, como aquellas que se encuentran en el transporte de radiancia.
Fundamentos Conceptuales: Discrepancia y Distribución Uniforme
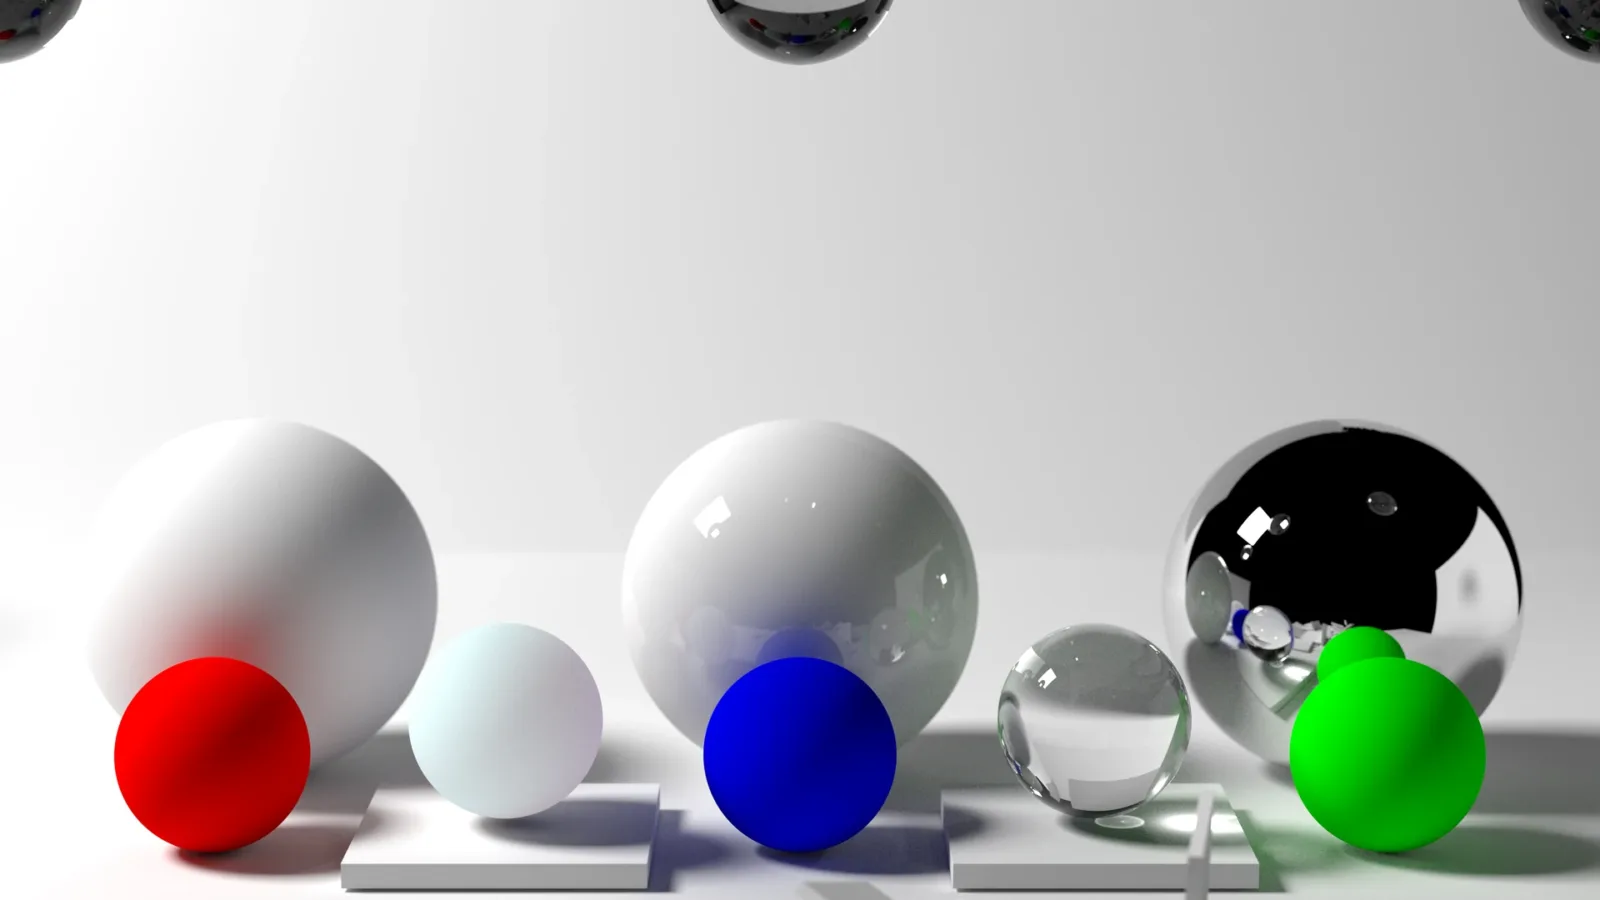
La noción de baja discrepancia
Discrepancia
Los fundamentos teóricos se basan en expresar cualquier entero positivo como una secuencia ordenada de dígitos dentro de una base numérica elegida—una representación que es única para cada valor y que constituye la base de la construcción del utilizada en toda esta familia de muestreadores.
La Transformación Inversa Radical
La operación fundamental que subyace tanto a los puntos de Hammersley como a las secuencias de Halton es la . Esta transformación convierte un entero no negativo en una coordenada fraccionaria dentro del intervalo unidad, reflejando la secuencia de dígitos de ese entero respecto al punto de radicación. Concretamente, si un entero posee dígitos en la base b, entonces invertir esos dígitos para que ocupen posiciones posteriores al punto decimal produce su valor de inverso radical.
Una ilustración concreta aclara el mecanismo: expresado e invertido en base diez, el número 1234 se convierte en 0.4321. El mismo principio se aplica a cualquier base arbitraria, ya sea prima o compuesta, lo que precisamente permite la construcción multidimensional mediante bases independientes por dimensión.
Mecánicas Técnicas de las Secuencias Cuasi-Aleatorias
La Secuencia de van der Corput
La constituye una de las secuencias de baja discrepancia más simples y sirve como bloque de construcción unidimensional para construcciones más elaboradas. Se define directamente aplicando la función de inverso radical en base dos, lo que significa que los dígitos binarios de cada entero sucesivo se reflejan para producir su punto correspondiente en el intervalo unitario.
La construcción presenta una estructura recursiva elegante: divide repetidamente los intervalos de la línea unidimensional y coloca una muestra en el centro de cada subintervalo recién formado. Esta división a la mitad autosimilar garantiza que la cobertura permanezca densa sin dejar nunca grandes regiones vacías, siempre que el número total de muestras se elija como una potencia de dos; de lo contrario, las separaciones entre muestras varían en tamaño mientras se mantiene una uniformidad razonable.
Es crucial que los puntos van der Corput formen una de finalización abierta, en lugar de un conjunto de puntos fijo: se pueden generar de forma consecutiva cualquier cantidad arbitraria de ellos sin que sea necesario determinar de antemano el número total. Esta propiedad resulta val para las tuberías de renderizado adaptativo, donde los presupuestos de muestreo pueden variar según la complejidad de la escena o las restricciones temporales.
La Secuencia de Halton en Dimensiones Superiores
La secuencia de Halton es un método para generar secuencias de baja discrepancia (secuencias quasi-aleatorias) en múltiples dimensiones. Fue propuesta por John Halton en 1964 y se basa en el concepto de radices prime o primas coprimas.
## Fundamentos Teóricos
La secuencia de Halton generaliza la secuencia de Van der Corput a dimensiones superiores. En una dimensión, la secuencia de Van der Corput utiliza una base prima r para generar valores distribuidos uniformemente en el intervalo [0, 1).
Para construir una secuencia en d dimensiones, se utiliza una lista de bases primas distintas. Cada dimensión emplea una base prima diferente, asegurando que las bases sean coprimas entre sí.
## Construcción de la Secuencia
El proceso de construcción implica los siguientes pasos:
1. Seleccionar una lista de bases primas: r₁, r₂, …, r_d para las d dimensiones
2. Para cada índice i, calcular la posición en cada dimensión usando la base prima correspondiente
3. Aplicar la inversión de dígitos en base r para cada dimensión
La fórmula general para la i-ésima término en la k-ésima dimensión es:
x_i,k = Σ(a_j,k / r_k^(j+1))
Donde a_j,k son los dígitos de i en base r_k.
## Ventajas de la Secuencia de Halton
La secuencia de Halton ofrece varias ventajas importantes:
– Distribución más uniforme que los métodos pseudo-aleatorios tradicionales
– Convergencia más rápida en integración numérica
– Determinista, lo que permite reproducibilidad de resultados
– Fácil implementación computacional
## Aplicaciones Prácticas
La secuencia de Halton se utiliza ampliamente en:
– Integración Monte Carlo para cálculo de integrales múltiples
– Simulaciones computacionales en física y finanzas
– Optimización de parámetros en machine learning
– Muestreo en espacios de alta dimensión
## Consideraciones de Implementación
Al implementar la secuencia de Halton, es importante seleccionar bases primas adecuadas. Las primeras bases primas comunes son 2, 3, 5, 7, 11, 13, etc. La elección de bases primas pequeñas puede introducir correlaciones no deseadas entre dimensiones.
Para mejorar la calidad de la secuencia, a veces se aplican técnicas de escrambling (barajado) que perturban ligeramente la secuencia manteniendo sus propiedades de baja discrepancia.
La generaliza la construcción unidimensional de van der Corput a dimensiones arbitrarias mediante el uso de una base distinta por dimensión, requiriendo que todas las bases sean primas entre sí para que sus reflexiones de dígitos permanezcan estadísticamente independientes a lo largo de los ejes. Una selección natural y estándar es la lista ordenada de números primos consecutivos—dos, tres, cinco, siete, once—ya que cada canal de coordenadas se apoya en su propio radix primo entre sí.
Al igual que la secuencia de van der Corput, los puntos de Halton pueden generarse de forma incremental sin conocer de antemano un número de muestras predeterminado: todo prefijo de la secuencia sigue estando bien distribuido, por lo que añadir muestras adicionales conserva la baja discrepancia durante toda la ejecución. La distribución alcanza una calidad óptima cuando el número total de muestras es un producto exacto de potencias de las bases elegidas; con otros recuentos aparecen pequeñas irregularidades, pero permanecen acotadas y, por lo general, son imperceptibles en la imagen renderizada.
La teórica para una secuencia de Halton dimensional disminuye a un ritmo que se aproxima, aunque nunca alcanza por completo, al escalamiento inverso cuadrático respecto al número de muestras—un comportamiento de convergencia que supera asintícticamente al decaimiento de error O-uno-over-raíz-de-N de la estimación de Monte Carlo mediante muestreo independiente, evitando por completo la maldición de la dimensionalidad.
El Conjunto de Puntos de Hammersley
Cuando la integración requiere un número fijo de muestras en lugar de un flujo ilimitado, el ofrece una discrepancia ligeramente menor mediante una ligera modificación estructural de la construcción de Halton. Un conjunto de Hammersley se compone tomando una coordenada como un simple índice lineal dividido por el número total de muestras y poblando todas las coordenadas restantes mediante funciones de inverso radical en bases coprimas—de manera efectiva, se intercambia una dimensión completamente aleatorizada por un eje uniformemente espaciado que garantiza una cobertura perfecta a lo largo de al menos una dirección.
Como las proyecciones bidimensionales de estos puntos se utilizan de forma rutinaria para localizar muestras en superficies de luz, geometría emisora y mapas de entorno, la disposición precisa influye directamente en los patrones de error visibles; incluso las regularidades sutiles pueden manifestarse como ruido estructurado en lugar de un grano inofensivo en la imagen compuesta.
Arquitectura de implementación: Fundamentos de aritmética de enteros
En la actualidad, la aritmética de enteros sigue siendo la base sobre la que se construyen la gran mayoría de los sistemas informáticos. Desde los microcontroladores más simples hasta los superordenadores más avanzados, la representación y el cálculo con números enteros constituye el cimiento sobre el que se apoya toda la lógica computacional.
## Fundamentos matemáticos de la aritmética de enteros
Los números enteros forman un conjunto cerrado respecto a las operaciones aritméticas básicas. Esto significa que la suma, la resta y el producto de dos enteros siempre produce otro entero. Sin embargo, la división no siempre preserva esta propiedad, lo que obliga a definir con precisión qué ocurre con el resto de la operación.
En matemáticas puras, los enteros se extienden infinitamente en ambas direcciones. Pero en la práctica computacional, el rango de valores representables es finito y está determinado por el número de bits disponibles. Esta limitación fundamental da lugar a comportamientos que a veces resultan contraintuitivos.
## Representación de enteros en el hardware
Existen varias formas de representar números enteros dentro del hardware. La más común es la notación en complemento a dos, que permite representar enteros con signo de manera eficiente. Esta representación simplifica enormemente las operaciones aritméticas, ya que la suma y la resta pueden implementarse con el mismo circuito básico.
La elección del formato de representación afecta directamente al rendimiento y a la precisión de los cálculos. Los procesadores modernos suelen incluir unidades aritmético-lógicas especializadas que operan directamente sobre enteros de anchos variables.
## Operaciones aritméticas fundamentales
La suma de enteros se implementa mediante circuitos llamados sumadores, que combinan las operaciones a nivel de bit. El carry o acarreo entre posiciones adyacentes es crucial para el correcto funcionamiento de estas operaciones. Los sumadores encadenados permiten construir operaciones de mayor anchura a partir de componentes más simples.
La resta se logra típicamente sumando el complemento a dos del sustraendo. Esta técnica unifica las operaciones y reduce la complejidad del hardware necesario. La multiplicación se construye a partir de sumas y desplazamientos sucesivos, mientras que la división utiliza restas y desplazamientos en una secuencia controlada.
## Manejo de desbordamientos y excepciones
Uno de los desafíos más importantes en la aritmética de enteros es el manejo de desbordamientos. Cuando el resultado de una operación excede el rango representable, el sistema debe decidir cómo responder. Algunas arquitectas permiten el desbordamiento silencioso, mientras que otras generan excepciones que deben ser manejadas explícitamente.
El manejo correcto de estas situaciones es esencial para la fiabilidad de los sistemas. Un desbordamiento no detectado puede producir resultados incorrectos que se propagan a través de cálculos posteriores, dificultando el diagnóstico de errores.
## Optimización de operaciones enteras
Los compiladores y los diseñadores de hardware aplican diversas técnicas para optimizar las operaciones enteras. La expansión de operaciones, el plegado de bucles y la selección inteligente de instrucciones son estrategias comunes que mejoran el rendimiento. La alineación de datos y el uso de instrucciones vectoriales también contribuyen a acelerar los cálculos.
La elección entre diferentes representaciones de enteros puede tener un impacto significativo en el rendimiento. En aplicaciones donde la precisión no es crítica, el uso de enteros de menor anchura permite ahorrar recursos y mejorar la eficiencia energética.
## Aplicaciones prácticas de la aritmética de enteros
La aritmética de enteros es fundamental en una amplia gama de aplicaciones. Desde el procesamiento de imágenes hasta la criptografía, pasando por los sistemas embebidos y los cálculos financieros, los enteros proporcionan una base sólida y predecible para el cómputo.
En el ámbito de la criptografía, las operaciones con enteros grandes son la base de muchos algoritmos de seguridad. La aritmética modular y el cálculo de funciones exponenciales enteras permiten implementar protocolos de comunicación seguros que protegen la información en tránsito.
## Conclusión
La aritmética de enteros permanece como un pilar fundamental de la computación moderna. Su comprensión profunda permite diseñar sistemas más eficientes, fiables y optimizados. A medida que la tecnología avanza, las técnicas para manejar la aritmética de enteros continuan evolucionando, adaptándose a las nuevas exigencias del cómputo de alto rendimiento.
Cálculo del Inverso Radical sin Error de Redondeo
El inverso radical es una función matemática fundamental en la generación de secuencias de baja discrepancia, especialmente en el contexto de los puntos de Van der Corput. La implementación tradicional puede sufrir de errores de redondeo debido a la representación en punto flotante de los números.
La clave para evitar estos errores reside en trabajar con aritmética entera o fraccionaria exacta. A continuación se presenta un método robusto para calcular el inverso radical utilizando operaciones enteras.
## El Concepto del Inverso Radical
El inverso radical de un número entero no negativo n en base b se define de la siguiente manera. Si n se expresa en base b como:
n = a₀ + a₁b + a₂b² + … + aₖbᵏ
entonces el inverso radical es:
inv(n) = a₀/b + a₁/b² + a₂/b³ + … + aₖ/bᵏ⁺¹
Este proceso efectivamente “refleja” los dígitos de n alrededor de la coma decimal.
## Implementación con Aritmética Entera
La forma más precisa de calcular el inverso radical evita por completo las operaciones de punto flotante durante el proceso de conversión. En su lugar, se construye un número racional representado por un numerador y un denominador enteros.
“python
def radical_inverse_exact(n, base):
numerator = 0
denominator = 1
factor = 1
while n > 0:
digit = n % base
numerator += digit factor
factor = base
n //= base
return numerator, denominator
`
Este método devuelve el resultado como una fracción exacta, eliminando cualquier posibilidad de error de redondeo.
## Ventajas del Enfoque Exacto
La principal ventaja de este método es la precisión garantizada. A diferencia de las implementaciones de punto flotante, que pueden acumular errores a medida que aumenta el número de dígitos, este enfoque produce resultados matemáticamente correctos para cualquier valor de entrada.
Además, al mantener los resultados como fracciones, es posible realizar operaciones adicionales con precisión antes de convertir finalmente a punto flotante si es necesario.
## Consideraciones sobre la Precisión
Es importante tener en cuenta que los enteros en la mayoría de los lenguajes de programación tienen un tamaño limitado. Para valores de n muy grandes o bases elevadas, el numerador puede crecer considerablemente. En tales casos, puede ser necesario utilizar librerías de enteros de precisión arbitraria.
La elección entre la representación de fracción exacta y la de punto flotante depende de las necesidades específicas de cada aplicación. Para la mayoría de los casos de simulación Monte Carlo, la precisión de punto flotante de doble precisión es suficiente, pero para aplicaciones que requieren exactitud matemática, el enfoque entero es preferible.
Una implementación robusta de estos muestreadores exige que toda la extracción y inversión de dígitos se realicen mediante , evitando deliberadamente la acumulación de punto flotante para impedir que los errores de redondeo degraden las coordenadas de muestreo a lo largo de secuencias largas. La rutina calcula el inverso radical de un número dado utilizando el primo especificado como base, extrayendo los dígitos de forma secuencial a partir del menos significativo y acumulándolos en una serie de valor entero en la que cada nuevo dígito se añade en posiciones escalonadas sucesivamente, determinadas por la multiplicación sucesiva del valor acumulado por el divisor.
El bucle algorítmico avanza dividiendo el acumulador actual por la base de trabajo; el resto producido en cada iteración constituye exactamente el dígito menos significativo que debe reflejarse e incorporarse al resultado. Dado que toda cantidad intermedia permanece como un entero exacto, no se pierde precisión alguna, independientemente de la longitud de la secuencia o del número de muestras.
# Conversión de punto flotante y factores de escala
## Introducción
La conversión de punto flotante es una técnica fundamental en el procesamiento de señales y la instrumentación digital. Permite transformar valores analógicos en representaciones numéricas que pueden ser procesadas por sistemas digitales, aplicando factores de escala apropiados para mantener la precisión y el rango dinámico deseado.
## Fundamentos de la representación de punto flotante
Los números de punto flotante siguen el estándar IEEE 754, que define cómo se almacenan los números reales en computadoras. Esta representación consta de tres componentes principales:
- Signo: un bit que indica si el número es positivo o negativo
- Exponente: representa la magnitud o escala del número
- Mantisa: contiene los dígitos significativos del número
## Factores de escala
Los factores de escala son multiplicadores que se aplican a los valores para ajustar su magnitud a un rango específico. Son esenciales cuando:
1. Se necesita adaptar señales de diferentes amplitudes
2. Se requiere optimizar el uso de la resolución disponible
3. Se deben mantener la precisión y evitar desbordamientos
### Cálculo de factores de escala
El factor de escala se calcula dividiendo el valor deseado entre el valor original:
`
factor_de_escala = valor_objetivo / valor_original
Este factor debe aplicarse de manera consistente en todo el sistema para garantizar la integridad de los datos.
## Conversión de punto flotante a enteros
Muchos sistemas digitales trabajan con números enteros por razones de eficiencia computacional. La conversión implica:
– Multiplicar el valor de punto flotante por el factor de escala
– Redondear al entero más cercano
– Almacenar o transmitir el resultado entero
Para revertir el proceso, se divide el valor entero entre el factor de escala.
## Aplicaciones prácticas
La conversión de punto flotante con factores de escala se utiliza ampliamente en:
– Procesamiento de señales de audio: para ajustar niveles de volumen
– Instrumentación científica: para medir variables físicas
– Gráficos por computadora: para representar colores y coordenadas
– Comunicaciones: para modular y demodular señales
## Consideraciones de precisión
Es importante tener en cuenta que la conversión de punto flotante puede introducir errores de redondeo. Para minimizar estos errores:
– Utilizar una resolución suficiente en la representación
– Aplicar técnicas de redondeo adecuadas
– Verificar el rango dinámico del sistema
## Conclusión
La comprensión de la conversión de punto flotante y los factores de escala es crucial para el diseño de sistemas digitales robustos y precisos. La selección adecuada de estos parámetros garantiza la calidad de los datos y la eficiencia del procesamiento.
Una vez que todos los dígitos han sido invertidos mediante operaciones enteras, la coordenada final surge al convertir el valor acumulado a punto flotante y multiplicarlo por un factor de escala igual a la inversa de la base elevada a la potencia correspondiente al número de dígitos extraídos durante el procesamiento. Esta normalización multiplicativa mapea con precisión la secuencia entera reflejada dentro del intervalo unitario, preservando la exactitud hasta los límites de representación del tipo de punto flotante objetivo. La escala recíproca suele precomputarse de forma incremental a medida que se procesan los dígitos, almacenándose en una variable como , de modo que no ocurra exponentiación adicional durante el bucle y el rendimiento permanezca óptimo para los bucles internos de muestreo más ajustados.
Cómputo de la Inversa Radical Inversa
Igualmente importante que la generación hacia adelante es la capacidad de invertir la transformación: dado una secuencia de dígitos reflejados ya revertida a su forma canónica, una rutina de recupera el índice entero original que la produjo. La inversión correcta requiere proporcionar el número total de dígitos presentes en el valor de origen como un parámetro explícito, ya que los ceros finales se pierden estructuralmente durante la reflexión—tanto 1234 como 123400 colapsan en formas invertidas idénticas, ya que los ceros añadidos se convierten en ceros iniciales tras la inversión de dígitos, lo que la representación entera estándar descarta. Proporcionar la longitud canónica disambigua estos casos y garantiza una fidelidad exacta de ida y vuelta entre la generación de índices y la recuperación de coordenadas.
Implicaciones competitivas: la randomización mediante el desorden
El problema de la determinista en los pipelines de renderizado
Una limitación fundamental compartida por ambos conjuntos de Hammersley y secuencias de Halton es su : dado que los puntos se generan mediante reglas aritméticas fijas, resulta imposible estimar la varianza de la integración mediante múltiples estimaciones independientes de una misma integral. La estimación de la varianza, un diagnóstico fundamental para el muestreo adaptativo, requiere independencia estadística que las construcciones deterministas niegan de forma inherente.
Una segunda deficiencia surge a medida que aumenta la dimensionalidad: las proyecciones de menor dimensión pueden revelar patrones geométricos regulares en lugar de parecer aleatorias. Estos artefactos estructurados son especialmente dañinos en el renderizado, ya que las proyecciones bidimensionales con frecuencia impulsan el muestreo de la fuente de luz y del entorno, donde la periodicidad visible se convierte en bandas de ruido reconocibles o reflejos fantasma en lugar de un grano de película aceptable.
Técnicas de Barajado para la Randomización Controlada
La solución reside en una familia de métodos denominados colectivamente (barajado), que randomizan los puntos generados por estos algoritmos mientras preservan su característica esencial de baja discrepancia. El enfoque más destacado permuta dígitos individuales mediante permutaciones aleatorizadas: se define, para cada base y cada posición de dígito, un reordenamiento bijectivo independiente aplicado al valor de esa coordenada antes de la reflexión o después de la extracción, dependiendo de la orientación de la implementación.
En todas las posibles permutaciones, cada coordenada resultante permanece uniformemente distribuida dentro del intervalo unitario, coincidiendo con la distribución marginal del muestreo aleatorio puro, al tiempo que conserva la cobertura conjunta superior de la generación cuasi-aleatoria. El efecto neto es un muestreador cuyas muestras se dispersan como ruido pseudo-aleatorio, pero que en conjunto cubre el espacio mucho más uniformemente, lo que produce imágenes con menor visibilidad de la variancia a igual número de muestras y permite una estimación robusta del error mediante la diversidad de permutaciones a través de pasadas independientes o teselas espaciales.
Perspectivas arquitectónicas: integración práctica en trazadores de rutas
Organización de cabeceras y límites de módulos
Las implementaciones en producción suelen aislar estas rutinas dentro de unidades de traducción dedicadas, como , junto con su correspondiente archivo complementario , exponiendo la inversa radical, su contraparte inversa y las funciones de permutación a través de una interfaz estable. Esta separación permite la generación por lotes y compatible con la caché de matrices de coordenadas antes de los bucles de muestreo, manteniendo las rutas de cálculo enteras separadas de las etapas de normalización de punto flotante, algo importante tanto para la verificación de la correcta como para las oportunidades de vectorización SIMD en los núcleos de renderizado de alto rendimiento.
Estrategia de Selección de Dimensionalidad
Al construir coordenadas de muestra multidimensionales, los profesionales deben seleccionar cuidadosamente las bases coprimas: los primeros primos siguen siendo estándar, pero a veces los diseñadores omiten los valores compuestos pequeños o sustituyen familias de primos alternativas para mitigar los artefactos de proyección de bajo orden conocidos que ciertas combinaciones de bases pueden producir para geometrías de escena específicas. La elección interactúa directamente con el número de dimensiones que un trazador de rutas asigna por operación de muestreo: normalmente dos coordenadas son suficientes para la colocación de superficies y luces, mientras que las tuplas de mayor dimensión permiten el muestreo de importancia conjunto de múltiples términos de transporte simultáneamente, sin correlación cruzada entre los ejes.
Consideraciones de Muestreo Temporal y Adaptivo
El muestreo temporal y adaptivo representa un enfoque fundamental para optimizar la eficiencia computacional en simulaciones y análisis de datos. La selección inteligente de momentos y condiciones bajo los cuales realizar mediciones permite reducir significativamente los recursos necesarios sin comprometer la precisión de los resultados.
La naturaleza dinámica de los sistemas complejos exige estrategias que puedan ajustarse dinámicamente a las condiciones variables. El muestreo adaptivo ofrece esta flexibilidad al modificar sus parámetros en función de la información recopilada durante el proceso. De esta manera, se concentran los esfuerzos en las regiones del espacio de parámetros donde la incertidumbre es mayor o donde los cambios son más pronunciados.
La dimensión temporal añade una capa adicional de complejidad. En muchos sistemas, el comportamiento evoluciona con el tiempo, y capturar este dinamismo requiere decisiones cuidadosas sobre cuándo realizar muestreos. Un muestreo demasiado disperso puede perder eventos importantes, mientras que un muestreo excesivamente denso desperdicia recursos valiosos.
Las técnicas modernas combinan ambos aspectos para desarrollar esquemas que equilibren precisión y eficiencia. Al integrar información histórica con predicciones futuras, estos métodos logran tomar decisiones informadas sobre el muestreo óptimo. Esta capacidad de aprendizaje continuo permite mejorar constantemente la calidad de las simulaciones a lo largo del tiempo.
Dado que estas secuencias toleran la generación incremental sin conteos predeterminados, se integran de forma natural con los esquemas de muestreo temporal (temporal supersampling) donde las posiciones de muestreo se acumulan a lo largo de los fotogramas; cada nuevo fotograma puede avanzar la secuencia de forma determinista, pero evita la repetición exacta que de otro modo produciría artefactos de parpadeo (flickering) en la salida animada. Combinadas con permutaciones de barajado (scrambling permutations) claveadas a semillas por fotograma o por bloque (tile), los trazadores de rutas (path tracers) logran tanto una convergencia estable como características de ruido visualmente agradables, lo que demuestra por qué la muestreo de baja discrepancia (low-discrepancy sampling) sigue siendo una técnica fundamental y no una curiosidad académica dentro de los modernos sistemas de renderizado en tiempo real y por lotes (offline) por igual.
Referencias académicas y lectura adicional
-
Pharr, M., Jakob, W., Humphreys, G. , 3rd edition. Morgan Kaufmann, 2016. (Chapters on sampling theory, low-discrepancy sequences, radical inverse construction, and scrambling techniques.)
-
Halton, J. H. “Sobre la eficiencia de ciertas secuencias no aleatorias de números en el cuadrado unitario.” , vol. 12, n.º 1, pp. 83–104, 1960.
-
Van der Corput, J. G. “Verteilung von Zahlen mod Eins.” , vol. 97, pp. 735–771, 1927.
-
Hammersley, J. M., Handscomb, D. C. . Chapman and Hall, 1964. (Tratamiento fundamental de conjuntos de puntos con baja discrepancia.)
-
Owen, A. B. “Métodos de Monte Carlo cuasi-azaroso alterado para la estimación de integrales con varianza finita.” , vol. 30, n.º 2, pp. 175-198, 2015. (Trabajo exhaustivo sobre las estrategias de alteración, que incluye los métodos de permutación de dígitos.)
-
Niederreiter, H. . SIAM, 1992. (Tratamiento matemático riguroso de las cotas de discrepancia y la construcción de secuencias de baja discrepancia en bases arbitrarias.)
-
Filippov, Y., et al. “Efficient Low Discrepancy Sampling for Real-Time Path Tracing.” , congresos relacionados con de implementaciones de muestreo quasi-Monte Carlo orientadas. (Perspectivas de ingeniería práctica sobre la integración de técnicas de barajado y generación incremental en renderizadores de producción.)
Have thoughts, questions, or benchmarks on this topic? Join the discussion on our forums.
Join Discussion ➔



Приєднуйтесь до розмови