Grundlagen der Niedrig-Diskrepanz-Stichprobe: Halton-Sequenzen, Hammersley-Mengen und ihre Rolle beim Pfadverfolgung
Einführung in die quasi-Monte-Carlo-Methoden beim Rendering
Die Bildsynthese, auch als Rendering bezeichnet, ist ein zentraler Bestandteil der Computergrafik und umfasst die Berechnung von Bildern mittels Algorithmen. Ein Bild wird dabei durch die Darstellung von Objekten erzeugt, die sich in einer virtuellen dreidimensionalen Umgebung befinden. Diese Objekte werden durch ihre geometrischen Eigenschaften sowie ihre Oberflächeneigenschaften beschrieben, während die Umgebung durch Lichtquellen, Kameras und andere visuelle Elemente definiert wird.

Um ein realistisches Bild zu erzeugen, müssen verschiedene physikalische Effekte berücksichtigt werden, wie zum Beispiel Lichtbrechung, Reflexion, Schattenwurf und Beugung. Diese Effekte sind jedoch oft sehr komplex und lassen sich nicht immer mit einfachen Algorithmen berechnen. Daher werden in der Praxis häufig Näherungsverfahren eingesetzt, um ein realistisches Bild zu erzeugen.
Eine dieser Näherungsmethoden ist die Monte-Carlo-Simulation. Hierbei wird das Bild durch die zufällige Auswahl von Lichtstrahlen simuliert, die von der Kamera ausgehen und mit den Objekten in der Szene interagieren. Durch die zufällige Auswahl der Lichtstrahlen kann die Komplexität der Berechnung reduziert werden, ohne dass die Qualität des Bildes stark leidet.
Allerdings hat die Monte-Carlo-Simulation auch einige Nachteile. So ist das Ergebnis der Simulation stark von der Anzahl der simulierten Lichtstrahlen abhängig. Je mehr Lichtstrahlen simuliert werden, desto genauer ist das Ergebnis, desto mehr Rechenzeit ist jedoch auch erforderlich. Zudem kann es bei der zufälligen Auswahl der Lichtstrahlen zu sogenannten “Rauschen” kommen, was die Qualität des Bildes beeinträchtigen kann.
Um diese Nachteile zu überwinden, wurden sogenannte quasi-Monte-Carlo-Methoden entwickelt. Diese Methoden basieren auf der Verwendung von quasi-zufälligen Zahlen, die eine gleichmäßigere Verteilung aufweisen als herkömmliche Zufallszahlen. Dadurch kann die Genauigkeit der Simulation erhöht werden, ohne dass die Rechenzeit stark ansteigt.
Quasi-Monte-Carlo-Methoden werden in der Praxis häufig bei der Bildsynthesis eingesetzt, um ein realistisches Bild zu erzeugen. Sie ermöglichen es, die Komplexität der Berechnung zu reduzieren, ohne dass die Qualität des Bildes stark leidet. Zudem können sie dazu beitragen, das Rauschen zu reduzieren und die Genauigkeit der Simulation zu erhöhen.
Insgesamt bieten quasi-Monte-Carlo-Methoden somit eine vielversprechende Möglichkeit, die Bildsynthesis zu verbessern und realistische Bilder zu erzeugen. Obwohl sie noch nicht vollständig erforscht sind, haben sie bereits in vielen Anwendungen gezeigt, dass sie eine effektive Methode zur Erzeugung von Bildern sein können.
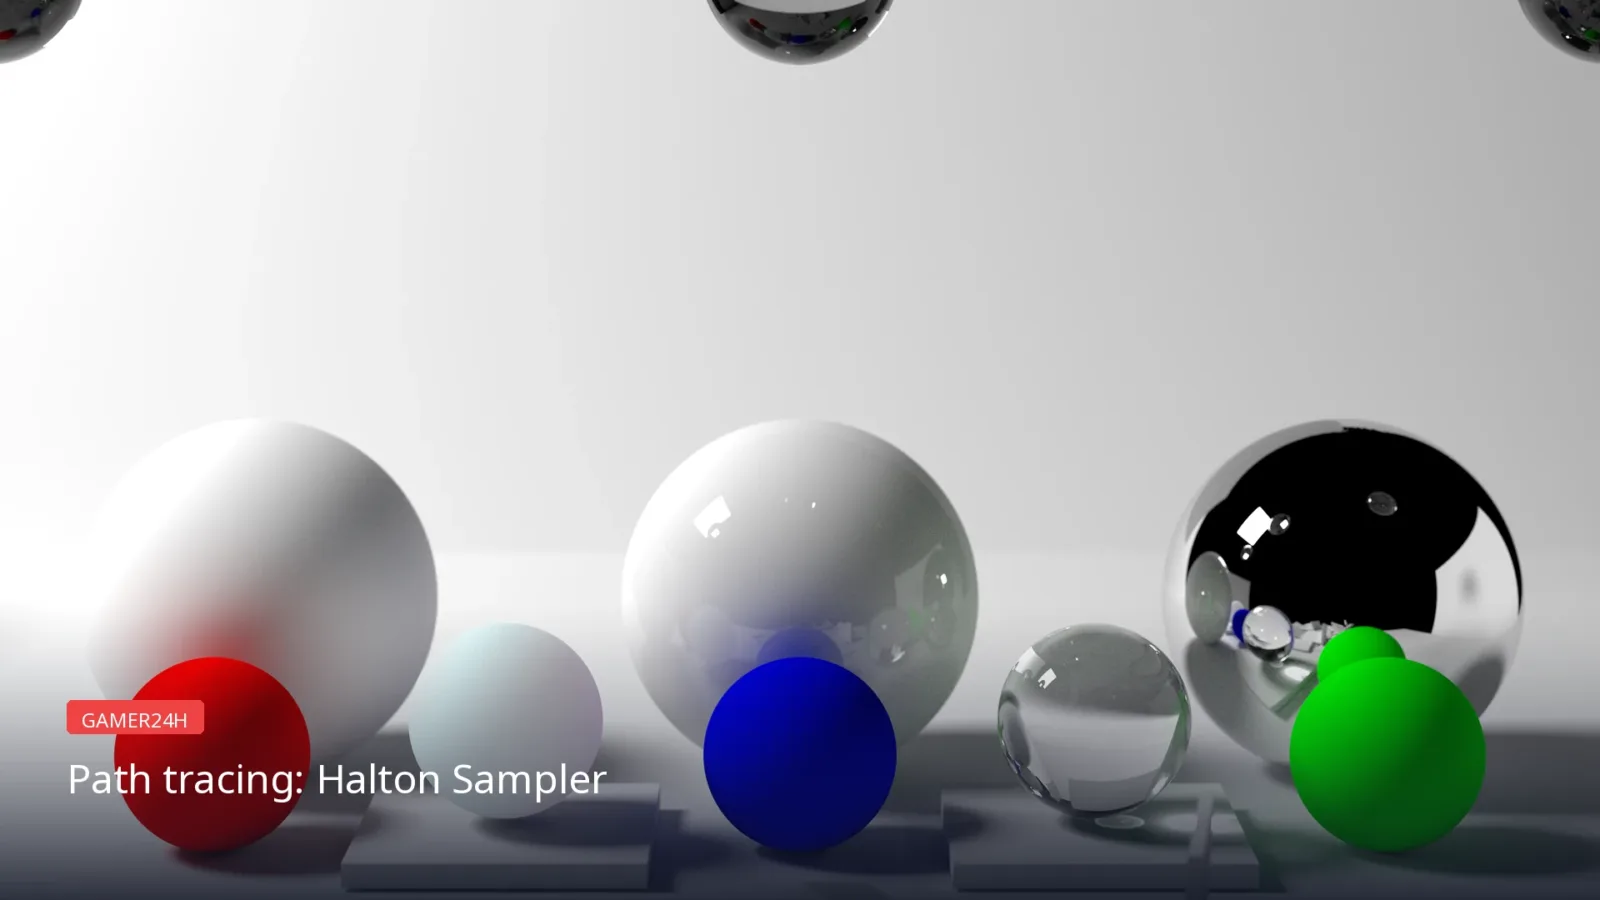
Das Pfadverfolgungsverfahren (Path Tracing) stützt sich grundlegend auf die Monte-Carlo-Integration, um die Rendering-Gleichung durch das Averagen stochastischer Auswertungen des Lichttransports zu schätzen. Die statistische Qualität eines Pfadverfolgungsverfahrens wird nicht allein durch die Anzahl der gezogenen Proben bestimmt, sondern durch im zugrunde liegenden Probenraum. Die naive, unabhängige gleichverteilte Stichprobennahme ist zwar unverzerrt, erzeugt jedoch Ballungen und Lücken, die die Varianz erhöhen; geschichtete Muster verbessern die räumliche Abdeckung auf Kosten von Randartefakten zwischen den Schichten. Die hier beschriebene Technikklasse——bietet eine ergänzende Strategie: deterministische Punktmengen, die so konstruiert sind, dass sie gleichzeitig in jeder Dimension des Probenraums gut verteilt sind, statt nur jeweils einzeln in einer oder zwei Dimensionen betrachtet gut verteilt zu sein.
Das zentrale Ziel, das alle derartigen Sampler gemeinsam haben, besteht darin, eine Menge von Punkten zu erzeugen, die sind, sodass keine zwei Samples einander übermäßig nahe liegen und keine Region des Stichprobenraums so groß wird, dass sie gänzlich ungesampelt bleibt. Diese Eigenschaft, die formell als geringe Diskrepanz oder hohe Uniformität bezeichnet wird, reduziert direkt den Integrationsfehler für glatte Integranden, wie sie beim Strahlungstransport auftreten.
Konzeptionelle Grundlagen: Diskrepanz und gleichmäßige Verteilung
Der Begriff der geringen Diskrepanz
Unregelmäßigkeit
Die theoretische Grundlage beruht auf der Darstellung jeder positiven ganzzahligen Zahl als geordnete Ziffernfolge in einer gewählten Zahlengrundlage—einer Darstellung, die für jeden Wert eindeutig ist und die Basis der im Rahmen dieser Samplerfamilie verwendeten bildet.
Die Radikale-Inverse-Transformation
Die zugrunde liegende Grundoperation sowohl bei den Hammersley-Punkten als auch bei den Halton-Seenzen ist die . Diese Transformation wandelt eine nichtnegative ganze Zahl in eine gebrochene Koordinate innerhalb der Einheitsintervalls um, indem sie die Ziffernfolge dieser Zahl am Kommapunkt gespiegelt wird. Konkret bedeutet dies: Besitzt eine ganze Zahl Ziffern zur Basis b, so ergeben die umgekehrten Ziffern, die nach dem Komma platziert werden, ihren Radikal-Inverse-Wert.
Eine konkrete Veranschaulichung erläutert den Mechanismus: In der Zehnerbasis ausgedrückt und umgekehrt, wird aus der Zahl 1234 die 0,4321. Das gleiche Prinzip gilt für jede beliebige Prim- oder zusammengesetzte Basis, was genau die mehrdimensionale Konstruktion durch unabhängige Basen je Dimension ermöglicht.
# Technische Mechanik quasi-zufälliger Sequenzen
## Einleitung
Die Theorie quasi-zufälliger Sequenzen bildet ein fundamentales Konzept in der numerischen Mathematik und der computergestützten Integration. Im Gegensatz zu rein zufälligen Sequenzen bieten quasi-zufällige Sequenzen eine gleichmäßigere Verteilung, was sie für zahlreiche Anwendungen in der Simulation und Numerik besonders attraktiv macht.
## Grundlegende Konzepte
### Definition quasi-zufälliger Sequenzen
Eine quasi-zufällige Sequenz ist eine Folge von Punkten im Einheitsquadrat, die eine besonders gleichmäßige Verteilung aufweist. Der zentrale Messparameter hierfür ist die Unregelmäßigkeit (Discrepancy), die quantifiziert, wie stark die Verteilung der Punkte von einer idealen gleichmäßigen Verteilung abweicht.
### Der Satz von Weyl
Ein wichtiger theoretischer Grundstein ist der Satz von Weyl, der das asymptotische Verhalten von Sequenzen wie der Van-der-Corput-Sequenz beschreibt. Dieser Satz stellt sicher, dass bestimmte deterministische Sequenzen gleichmäßig auf dem Einheitsintervall verteilt sind.
## Wichtige Konstruktionstechniken
### Van-der-Corput-Sequenz
Die Van-der-Corput-Sequenz ist eine der einfachsten und wichtigsten quasi-zufälligen Sequenzen. Sie wird durch Spiegelung der Ziffern einer Zahl in einer bestimmten Basis erzeugt. Für die Basis b wird die Zahl n in das Basissystem umgewandelt und die Ziffern werden an der Kommastelle gespiegelt.
### Halton-Sequenz
Die Halton-Sequenz verallgemeinert die Van-der-Corput-Sequenz auf mehrere Dimensionen. Dabei werden für jede Dimension verschiedene, zueinander primische Basen verwendet, um eine gleichmäßige Verteilung im mehrdimensionalen Raum zu erreichen.
### Sobol-Sequenz
Die Sobol-Sequenz gehört zu den am häufigsten verwendeten quasi-zufälligen Sequenzen in der Praxis. Sie basiert auf digitalen Konstruktionstechniken und ermöglicht eine effiziente Berechnung in hohen Dimensionen.
## Mathematische Eigenschaften
### Gleichmäßigkeit und Unregelmäßigkeit
Der Grad der Gleichmäßigkeit wird durch verschiedene Unregelmäßigkeitsmaße quantifiziert:
– Starke Unregelmäßigkeit (Star Discrepancy)
– Lebesgue-Unregelmäßigkeit
– Variation nach Hardy und Krause
Diese Maße sind entscheidend für die Bewertung der Qualität verschiedener quasi-zufälliger Sequenzen.
## Anwendungen
### Monte-Carlo-Integration
Eine der wichtigsten Anwendungen quasi-zufälliger Sequenzen ist die Quasi-Monte-Carlo-Integration. Durch die Verwendung gleichmäßig verteilter Punkte kann die Konvergenzrate im Vergleich zu klassischen Monte-Carlo-Methoden erheblich verbessert werden.
### Finanzmathematik
In der Finanzmathematik werden quasi-zufällige Sequenzen zur Bewertung komplexer Finanzinstrumente eingesetzt. Die verbesserte Konvergenz ermöglicht präzisere Berechnungen bei der Optionspreisfindung und Risikobewertung.
## Praktische Implementierung
Die Implementierung effizienter Algorithmen für quasi-zufällige Sequenzen erfordert sorgfältige Berücksichtigung verschiedener Faktoren:
1. Wahl geeigneter Basen für die verschiedenen Dimensionen
2. Numerische Stabilität bei der Berechnung
3. Effizienz bei der Generierung hoher Punktzahlen
## Fazit
Quasi-zufällige Sequenzen stellen ein mächtiges Werkzeug in der numerischen Mathematik dar. Ihr Wert liegt in der verbesserten Gleichmäßigkeit im Vergleich zu rein zufälligen Sequenzen, was zu präziseren Ergebnissen bei zahlreichen numerischen Anwendungen führt. Die kontinuierliche Forschung in diesem Bereich versetzt uns in die Lage, noch effizientere Algorithmen für komplexe Probleme zu entwickeln.
Die van-der-Corput-Sequenz
Die zählt zu den einfachsten Sequenzen mit niedriger Diskrepanz und dient als eindimensionales Grundelement für aufwendigere Konstruktionen. Sie wird direkt durch Anwendung der Radikal-Invers-Funktion zur Basis zwei definiert, was bedeutet, dass die Binärziffern der jeweiligen nächsten ganzen Zahl zur Erzeugung des entsprechenden Punktes auf dem Einheitsintervall gespiegelt werden.
Der Aufbau weist eine elegante rekursive Struktur auf: Er teilt wiederholt Intervalle der eindimensionalen Linie und platziert jeweils eine Stichprobe in der Mitte jedes neu entstandenen Teilintervalls. Diese selbstähnliche Halbierung gewährleistet, dass die Abdeckung dicht bleibt, ohne jemals große leere Bereiche zu hinterlassen, vorausgesetzt nur, dass die Gesamtzahl der Stichproben als Potenz von zwei gewählt wird; andernfalls schwanken die Abstände zwischen den Stichproben in ihrer Größe, behalten dabei jedoch eine vernünftige Gleichmäßigkeit.
Entscheidend ist dabei, dass van-der-Corput-Punkte eine offene bilden und keine feste Punktmenge: Sie lassen sich beliebig häufig in Folge erzeugen, ohne dass die Gesamtzahl vorher festgelegt werden müsste. Diese Eigenschaft erweist sich als wertvoll für adaptive Rendering-Pipelines, in denen sich die Sample-Budgets je nach Szenenkomplexität oder zeitlichen Randbedingungen ändern können.
# Die Halton-Sequenz in höheren Dimensionen
Die Halton-Sequenz ist eine Methode zur Erzeugung von quasirandomen Punkten, die sich durch eine gleichmäßigere Verteilung auszeichnen als herkömmliche Zufallszahlen. Während die ursprüngliche Van-der-Corpus-Sequenz nur eine einzelne Dimension abdeckt, ermöglicht die Erweiterung auf höhere Dimensionen den Einsatz in komplexen numerischen Anwendungen.
## Grundprinzip der Halton-Sequenz
Die Halton-Sequenz basiert auf dem Konzept der Primzahlbasen. Für jede Dimension wird eine andere Primzahl als Basis verwendet. Der Kernalgorithmus funktioniert wie folgt:
1. Wähle eine Primzahl als Basis
2. Teile die Indizes der Sequenz wiederholt durch diese Primzahl
3. Stelle die resultenden Werte in der jeweiligen Basis dar
4. Addiere die erhaltenen Werte zur Erzeugung der Punkte
## Erweiterung auf mehrere Dimensionen
Bei der Arbeit mit höheren Dimensionen ist die sorgfältige Auswahl der Primzahlen entscheidend. Die ersten Primzahlen (2, 3, 5, 7, 11, 13, …) werden typischerweise als Basen verwendet. Jede Dimension erhält eine eigene Primzahl, wodurch die Korrelationen zwischen den Dimensionen minimiert werden.
### Wichtige Aspekte bei der Dimensionenerweiterung
– Primzahlwahl: Die Wahl geeigneter Primzahlen beeinflusst maßgeblich die Qualität der Sequenz
– Gleichmäßigkeit: Höherdimensionale Anwendungen erfordern besondere Aufmerksamkeit auf die Verteilung
– Numerische Stabilität: Bei vielen Dimensionen können Rundungsfehler auftreten
## Anwendungen in höheren Dimensionen
Die Halton-Sequenz findet in verschiedenen Bereichen Anwendung:
– Monte-Carlo-Simulationen
– Numerische Integration
– Optimierungsalgorithmen
– Computergrafik und Rendering
## Praktische Implementierung
Bei der Implementierung in höheren Dimensionen sollten folgende Punkte beachtet werden:
“
// Beispiel für die Generierung von Halton-Punkten

// Jede Dimension verwendet eine eigene Primzahl als Basis
Die korrekte Implementierung erfordert sorgfältige Behandlung der numerischen Genauigkeit, besonders bei der Arbeit mit vielen Dimensionen.
## Fazit
Die Halton-Sequenz in höheren Dimensionen bietet eine leistungsstarke Methode für die Erzeugung gleichverteilter Punkte. Die richtige Wahl der Primzahlen und die sorgfältige Behandlung numerischer Aspekte sind entscheidend für die Qualität der Ergebnisse.
Die verallgemeinert die eindimensionale Konstruktion nach van der Corput auf beliebige Dimensionen, indem je Dimension eine eigene Basis verwendet wird, wobei alle Basiswerte paarweise teilerfremd sein müssen, damit ihre Ziffernreflexionen über die Achsen hinweg statistisch unabhängig bleiben. Eine naheliegende und übliche Wahl ist die geordnete Liste aufeinanderfolgender Primzahlen—zwei, drei, fünf, sieben, elf—da jeder Koordinatenkanal seine eigene teilerfremde Basis verwendet.
Ähnlich wie die van-der-Corput-Folgen lassen sich Halton-Punkte inkrementell erzeugen, ohne dass eine vorher festgelegte Stichprobenzahl bekannt sein muss: Jede Präfixsequenz bleibt gleichmäßig verteilt, sodass das Anhängen weiterer Proben die geringe Diskrepanz während der gesamten Ausführung aufrechterhält. Die Verteilung erreicht ihre optimale Qualität, wenn die Gesamtzahl der Proben einem exakten Produkt aus Potenzen der gewählten Basen entspricht; bei anderen Zahlen treten geringfügige Unregelmäßigkeiten auf, die jedoch begrenzt bleiben und in der gerenderten Ausgabe in der Regel unauffällig sind.
Die theoretische für eine Halton-Sequenz in höheren Dimensionen nimmt mit wachsender Stichprobengröße mit einer Rate ab, die sich einer quadratischen Inversskalierung annähert, ohne sie jedoch jemals vollständig zu erreichen. Dieses Konvergenzverhalten übertrifft asymptotisch den reinen Monte-Carlo-Fehlerabfall mit O(1/√N) bei unabhängiger Stichprobenziehung, umgeht dabei jedoch gleichzeitig vollständig den Fluch der Dimensionalität.
Die Hammersley-Punktmenge
Wenn die Integration eine feste Anzahl von Stichproben erfordert, anstatt eines offenen Datenstroms, bietet die durch eine leichte strukturelle Modifikation der Halton-Konstruktion eine geringfügig niedrigere Diskrepanz. Eine Hammersley-Menge wird dadurch gebildet, dass eine Koordinate als einfacher linearer Index, geteilt durch die gesamte Stichprobenanzahl, verwendet und alle übrigen Koordinaten über Radikal-Inverse-Funktionen in teilerfremden Basen aufgefüllt werden – wodurch effektiv eine vollständig durcheinandergewürfelte Dimension gegen eine gleichmäßig verteilte Achse eingetauscht wird, die eine perfekte Abdeckung in mindestens einer Richtung garantiert.
Da zweidimensionale Projektionen dieser Punkte routinemäßig zur Lokalisierung von Proben auf Lichtflächen, emissiver Geometrie und Environment Maps verwendet werden, beeinflusst die präzise Anordnung direkt die sichtbaren Fehlermuster; selbst subtile Regularitäten können sich in dem zusammengesetzten Bild als strukturiertes R statt als harmloses Körnen manifestieren.
Implementierungsvorlage: Grundlagen der Integer-Arithmetik
Berechnung des Radix-Inverse-Algorithmus ohne Rundungsfehler
Eine robuste Implementierung dieser Sampler erfordert, dass alle Ziffernentfernungen und -umkehrungen ausschließlich über die reinen erfolgen, wobei bewusst auf die Akkumulation von Gleitkommazahlen verzichtet wird, um zu verhindern, dass Rundungsfehler die Sample-Koordinaten über lange Sequenzen hinweg verfälschen. Die Routine berechnet den radikalen Inversen einer gegebenen Zahl mithilfe des angegebenen Primfaktors als Basis, indem die Ziffern sequenziell beginnend von der unwichtigsten Ziffer extrahiert werden, und sammelt sie dann in einer ganzzahligen Reihe, bei der jede neue Ziffer an zunehmend skalierten Positionen hinzugefügt wird, die durch die successive Multiplikation des laufenden Werts und des Divisors bestimmt werden.
Die algorithmische Schleife läuft ab, indem der aktuelle Akkumulator durch die Arbeitsbasis geteilt wird; der in jeder Iteration entstehende Rest bildet exakt die signifikanteste Ziffer, die gespiegelt und in die Ausgabe integriert werden muss. Da jede Zwischenmenge eine ganzzahlige Größe bleibt, geht unabhängig von der Sequenzlänge oder der Anzahl der Stichproben keine Genauigkeit verloren.
Umrechnung von Fließkommawerten und Skalierungsfaktoren
Sobald alle Ziffern durch ganzzahlige Operationen umgekehrt wurden, ergibt sich die endgültige Koordinate durch die Umrechnung des angesammelten Werts in eine Gleitkommadarstellung und die Multiplikation mit einem Skalierungsfaktor, der Eins geteilt durch die Basis hoch der Zahl der während der Verarbeitung extrahierten Ziffern entspricht. Diese multiplikative Normierung bildet die gespiegelte Ganzzahlsequenz präzise in das Einheitsintervall ab und bewahrt die Genauigkeit bis zu den darstellungsbedingten Grenzen des jeweiligen Gleitkommatyps. Der Kehrwert der Skalierung wird in der Regel inkrementell während der Verarbeitung der Ziffern vorberechnet und in einer Variablen wie gespeichert, damit innerhalb der Schleife keine zusätzliche Exponentiation stattfindet und die Leistung in engen inneren Sampling-Schleifen optimal bleibt.
Inverses Radikal-Inversberechnung
Gleichermaßen wichtig wie die Vorwärtserzeugung ist die Fähigkeit, die Transformation zu invertieren: Für eine bereits in ihre kanonische Form zurücktransformierte reflektierte Ziffernfolge ermittelt eine Routine zur inversen Radix-Inversion den ursprünglichen Index, der diese erzeugt hat. Die korrekte Inversion erfordert die explizite Angabe der Gesamtzahl der im Ausgangswert vorhandenen Ziffern als Parameter, da am Ende angehängte Nullen bei der Spiegelung strukturell verloren gehen—sowohl 1234 als auch 123400 ergeben identische umgekehrte Darstellungen, da angehängte Nullen nach der Ziffernumkehrung zu führenden Nullen werden, die die übliche ganzzahlige Darstellung verwirkt. Die Angabe der kanonischen Länge hebt diese Mehrdeutigkeit auf und gewährleistet eine exakte Rundlaufgenauigkeit zwischen Indexerzeugung und Koordinatenrückführung.
Wettbewerbsimplikationen: Randomisierung durch Durcheinander
Das Determinismus-Problem in Rendering-Pipelines
Eine fundamentale Einschränkung, die sowohl Hammersley-Sets als auch Halton-Sequenzen gemeinsam haben, ist ihre : Da die Punkte durch feste arithmetische Regeln erzeugt werden, ist es unmöglich, die Integrationsvarianz über mehrere unabhängige Schätzungen eines einzelnen Integrals zu bestimmen. Die Varianzschätzung—ein Grundpfeiler der adaptiven Stichprobennahme—erfordert eine statistische Unabhängigkeit, die deterministische Konstruktionen von vornherein ausschließen.
Eine zweite Mänglichkeit tritt zutage, wenn die Dimensionalität zunimmt: Niedrigdimensionale Projektionen können regelmäßige geometrische Muster offenbaren, anstatt zufällig zu erscheinen. Diese strukturierten Artefakte sind beim Rendern besonders schädlich, da zweidimensionale Projektionen häufig die Lichtquellen- und Umgebungsstichprobe steuern, wo sichtbare Periodizität sich in erkennbare Rauschbänder oder gespenstische Highlights verwandelt, anstatt eines akzeptablen Filmkorns.
# Scrambling-Techniken für eine kontrollierte Randomisierung
Scrambling-Techniken sind essentielle Werkzeuge in der modernen Datenverarbeitung und Kryptographie, die eine kontrollierte Randomisierung ermöglichen. Diese Verfahren werden in verschiedenen Anwendungsbereichen eingesetzt, von der Signalverarbeitung über die Datensicherheit bis hin zur Optimierung von Algorithmen.
## Grundprinzipien des Scrambling
Das Kernkonzept beim Scrambling besteht darin, die Reihenfolge von Elementen oder Daten so zu verändern, dass ein deterministischer, aber schwer vorhersehbarer Effekt entsteht. Im Gegensatz zu einer zufälligen Randomisierung bleibt der Scrambling-Prozess jedoch reproduzierbar, wenn ein entsprechender Schlüssel oder Parameter verwendet wird.
### Vorteile kontrollierter Randomisierung
Die kontrollierte Randomisierung bietet mehrere entscheidende Vorteile gegenüber rein zufallsbasierten Ansätzen. Zunächst einmal ermöglicht sie die Reversibilität, was bedeutet, dass der Originalzustand durch einen Entscrambling-Prozess wiederhergestellt werden kann. Diese Eigenschaft ist besonders wichtig in Anwendungen, bei denen Datenintegrität und Nachvollziehbarkeit eine zentrale Rolle spielen.
## Typische Scrambling-Algorithmen
Es existieren verschiedene Algorithmen zum Scrambling, jeder mit eigenen Charakteristiken und Anwendungsgebieten. Zu den gängigen Methoden gehören Permutationsalgorithmen, die Elemente basierend auf bestimmten Regeln neu ordnen, sowie bitweise Operationen, die die Darstellung von Daten auf niedriger Ebene verändern.
### Implementierungsaspekte
Bei der Implementierung von Scrambling-Techniken müssen verschiedene Faktoren berücksichtigt werden. Die Rechenkomplexität, die Qualität der Randomisierung und die Sicherheit des verwendeten Schlüssels sind dabei besonders relevante Aspekte. Eine sorgfältige Abwägung dieser Faktoren ist notwendig, um eine optimale Leistung zu gewährleisten.
## Anwendungsbereiche
Scrambling-Techniken finden in zahlreichen Bereichen Anwendung. In der Kryptographie dienen sie der Verschlüsselung von Informationen, in der Signalverarbeitung zur Vermeidung von Störungen und in der Informatik zur Verbesserung der Effizienz von Datenstrukturen.
### Zukunftsaussichten
Die weitere Entwicklung von Scrambling-Techniken verspricht interessante Neuerungen. Durch die zunehmende Digitalisierung und die wachsende Bedeutung von Datensicherheit wird die Bedeutung kontrollierter Randomisierung weiterhin zunehmen. Forschung und Praxis werden voraussichtlich innovative Ansätze hervorbringen, die den bestehenden Techniken neue Dimensionen verleihen.
Die Lösung liegt in einer Methodenfamilie, die gemeinsam als bezeichnet wird und die von diesen Algorithmen erzeugten Punkte randomisiert, dabei aber ihren wesentlichen Niedrig-Diskrepanz-Charakter beibehält. Die weithin bekannteste Methode vertauscht einzelne Ziffern durch randomisierte Permutationen: Dabei wird je nach Basis und je nach Ziffernposition eine unabhängige bijektive Umordnung definiert, die auf den Wert dieser Koordinate angewendet wird – vor der Reflexion oder nach der Extraktion, je nach Ausrichtung der jeweiligen Implementierung.
Über alle möglichen Permutationen bleibt die jeweilige Koordinate gleichverteilt über das Einheitsintervall – entsprechend der Randverteilung rein zufälliger Stichproben, wobei die überlegene gemeinsame Abdeckung durch die quasi-zufällige Erzeugung erhalten bleibt. Der Nettoeffekt ist ein Sampler, dessen Stichproben wie pseudozufälliges Rauschen verstreut sind, aber gemeinsam den Raum deutlich gleichmäßiger abdecken, was bei gleicher Anzahl von Stichproben Bilder mit geringerem sichtbaren Varianz aufweist und eine robuste Fehlerabschätzung durch Permutationsvielfalt über unabhängige Durchgänge oder räumliche Kacheln ermöglicht.
Architekturelle Einblicke: Praktische Integration in Pfadtracer
Header-Organisation und Modulegrenzen
Produktionsimplementierungen isolieren diese Routinen üblicherweise in dedizierten Translation Units wie zusammen mit einer entsprechenden -Begleitdatei und stellen über eine stabile Schnittstelle die Radikalinverse, deren Gegenstück sowie die Permutationshilfen zur Verfügung. Diese Trennung ermöglicht eine cache-freundliche, vorauseilende Batch-Generierung von Koordinatenarrays vor den Sampling-Schleifen, während die rein ganzzahligen Berechnungspfade von den Fließkomma-Normierungsstadien getalten werden—wichtig sowohl für die Korrektheitsverifikation als auch für die Möglichkeiten der SIMD-Vektorisierung in durchsatzstarken Render-Kernels.
Strategie zur Auswahl der Dimensionalität
Bei der Konstruktion multidimensionaler Stichprobenkoordinaten müssen Praktiker sorgfältig zueinander teilerfremde Basen auswählen: Die ersten mehreren Primzahlen bleiben Standard, doch Entwickler überspringen gelegentlich kleine, zusammengesetzte Werte begünstigende Zahlen oder ersetzen alternative Primzahlfamilien, um bekannte Projektionsartefakte niedriger Ordnung zu mindern, die bestimmte Basenkombinationen für spezifische Szenengeometrien erzeugen können. Die Wahl steht in direktem Zusammenhang mit der Anzahl der Dimensionen, die ein bestimmter Pfadtracer pro Sampling-Operation zuordnet: In der Regel genügen zwei Koordinaten für die Platzierung von Oberfläche und Licht, während höherdimensionale Tupel das gemeinsame Importance Sampling mehrerer Transportterme gleichzeitig ohne Kreuzkorrelation zwischen den Achsen ermöglichen.
Temporale und adaptive Abtastbetrachtungen
Da diese Sequenzen eine inkrementelle Generierung ohne vorher festgelegte Zähler unterstützen, fügen sie sich nahtlos in zeitliche Supersampling-Verfahren ein, bei denen sich die Sample-Positionen über die Frames hinweg aufsummieren; jeder neue Frame kann die Sequenz deterministisch weiterführen, dennoch aber eine exakte Wiederholung vermeiden, die sonst bei animierten Ausgaben zu Flackerartefakten führen würde. Kombiniert mit durch pro-Frame- oder pro-Kachel-Seds gesteuerten Scrambling-Permutationen erreichen Path-Tracer sowohl eine stabile Konvergenz als auch visuell ansprechende Rauschcharakteristiken – was eindrucksvoll zeigt, warum Low-Discrepancy-Sampling eine grundlegende Technik bleibt und keine rein akademische Kuriosität, und das sowohl in modernen Echtzeit- als auch in Offline-Rendering-Systemen.
Akademische Literaturangaben und weiterführende Informationen
-
Pharr, M., Jakob, W., Humphreys, G. , 3. Auflage. Morgan Kaufmann, 2016. (Kapitel über Abtasttheorie, Sequenzen mit niedriger Diskrepanz, Konstruktion des Radikalinversen sowie Techniken zum Scrambling.)
-
Halton, J. H. „Über die Effizienz bestimmter nicht-zufälliger Zahlenfolgen im Einheitsquadrat.” , Bd. 12, Nr. 1, S. 83–104, 1960.
-
Van der Corput, J. G.: „Verteilung von Zahlen mod Eins.” , Bd. 97, S. 735–771, 1927.
-
Hammersley, J. M., Handscomb, D. C. . Chapman and Hall, 1964. (Grundlegende Behandlung von Punktfolgen mit niedriger Diskrepanz.)
-
Owen, A. B. „Scrambled Quasi-Monte-Carlo-Methoden für die Integralabschätzung mit endlicher Varianz.” , Band 30, Nr. 2, S. 175–198, 2015. (Umfassende Übersicht über Scrambling-Strategien einschließlich Ziffernpermutationsverfahren.)
-
Niederreiter, H. . SIAM, 1992. (Strenge mathematische Behandlung von Diskrepanzschranken und Konstruktion von Gleichverteilungssequenzen in beliebigen Basen.)
-
Filippov, Y., et al. „Effiziente Niedrig-Diskrepanz-Stichprobe für die Echtzeit-Pfadverfolgung.” , Proceedings im Zusammenhang mit -orientierten quasi-Monte-Carlo-Stichprobendurchführungen. (Praktische technische Perspektiven zur Integration von Scrambling und inkrementaler Generierung in produktive Renderer.)
Have thoughts, questions, or benchmarks on this topic? Join the discussion on our forums.
Join Discussion ➔



Alătură-te conversației