

The Greatest Contradiction in the Modern GPU Market
Le marché du matériel informatique a été le théâtre de l’un des paradoxes architecturaux les plus frappants de notre époque : alors que la carte d’entrée de gamme était livrée avec un généreux tampon de , des cartes graphiques nettement plus rapides et plus coûteuses, comme les , et , étaient strictement bridées à un maigre . Même le modèle phare destiné à la résolution 4K, la , était limité à seulement . Pendant ce temps, AMD passait à l’offensive en équipant la de 12 Go et en fixant une . Il ne s’agissait ni d’une erreur d’ingénierie ni d’un mauvais calcul logistique : NVIDIA avait anticipé l’explosion de la demande en calcul d’IA locale et en mémoire pour les moteurs de jeu modernes, et avait délibérément restreint les ressources des puces grand public afin de protéger les marges de ses solutions professionnelles et d’induire une obsolescence programmée.
1. Hiérarchie inversée : quand payer plus vous rapportait moins de VRAM
Dans la segmentation standard des produits GPU, les niveaux supérieurs augmentent de manière proportionnelle à la fois la puissance de calcul brute et la capacité mémoire. Avec Ampere, cependant, NVIDIA a proposé aux joueurs une hiérarchie inversée qui défiait la logique conventionnelle du matériel :
12 GB
Silicium GA106 | Bus à 192 bits. Malgré son positionnement économique, il bénéficie du plus large tampon mémoire de la gamme de milieu de gamme.

8 GB
Silicium GA104 | Bus à 256 bits. Une puissance de calcul impressionnante bridée par une limite stricte de 8 Go de mémoire tampon.
10 GB
Silicium GA102 | Bus à 320 bits. Commercialisé comme un champion incontesté du 4K, il est pourtant limité à seulement 10 Go de GDDR6X.
16 GB
Navi 21 Silicon | 256 bits + cache Infinity de 128 Mo. AMD a fixé 16 Go comme référence non négociable.
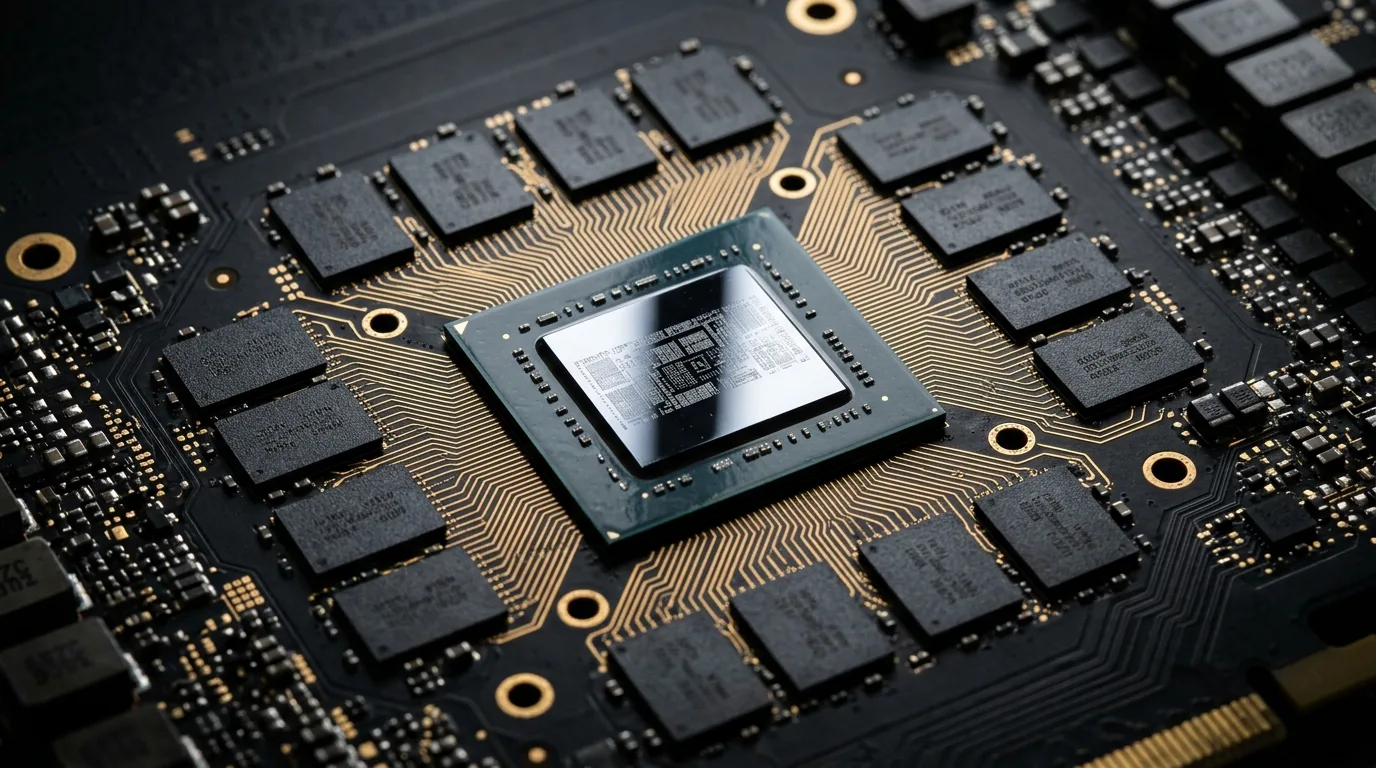
2. Le piège des 192 bits : pourquoi la 3060 a été dotée de 12 Go de mémoire de force
Les observateurs occasionnels confondaient souvent l’allocation de 12 Go de la RTX 3060 avec une générosité de la part de l’entreprise. En réalité, il s’agissait d’une contrainte technique inévitable, dictée par les calculs relatifs au bus mémoire :
- La contrainte physique de 192 bits :
- Le suicide commercial des 6 Go :buffer de 6 Go
- La main réticente de NVIDIA :buffer massif de 12 Go
La preuve irréfutable : pourquoi la carte graphique professionnelle RTX A4000 a-t-elle été dotée de 16 Go ?
Si NVIDIA avait pu allouer 12 Go à la gamme économique, pourquoi la RTX 3070, nettement plus performante, n’a-t-elle pas reçu 16 Go ? La puce GA104 dispose d’un (huit canaux de 32 bits). L’équiper de huit modules de 2 Go pour atteindre 16 Go aurait été une chose triviale.
3. Protéger les marges des entreprises face à la révolution locale de l’IA
Voici donc la stratégie fondamentale de l’entreprise. NVIDIA n’est plus simplement un fournisseur de matériel de jeu ; c’est désormais le gardien dominant de l’infrastructure mondiale de l’intelligence artificielle. Les marges des entreprises sur les accélérateurs pour centres de données (A100, H100, L40S) dépassent de plusieurs ordres de grandeur les bénéfices tirés des ordinateurs de bureau grand public.
Lors de l’exécution locale de grands modèles de langage à poids ouverts (Meta Llama 3 8B, Qwen 2.5, DeepSeek) ou de modèles de diffusion (Stable Diffusion, Flux) via Ollama, LM Studio ou ComfyUI, l’axiome fondamental de performance est absolu :
- L’empreinte mémoire des paramètres 8B :8,5 à 9,5 Go de VRAM
- L’effondrement de la RTX 3070 (8 Go) :
CUDA Out of Memory - La victoire de la RTX 3060 (12 Go) :
4. L’obsolescence programmée dans le jeu vidéo : le mur des 8 Go et les saccades
Dans les titres AAA sortis après 2023, basés sur DirectX 12 Ultimate et Unreal Engine 5, la VRAM n’est plus uniquement consommée par les cartes de textures brutes. Le tampon de mémoire est assailli par trois pipelines gourmands en ressources :
Répartition de la VRAM en 1440p / 4K dans les moteurs modernes :
2.0 – 2.5 GB
1.2 – 1.5 GB
7.0 – 8.5 GB
10.2 – 12.5 GB
Dans des sorties exigeantes comme , et , les propriétaires de cartes RTX 3070 ont rencontré une forte dégradation des performances, malgré une puissance de calcul GPU largement suffisante :
- Minimums catastrophiques à 1 % :
- Détérioration des textures :
- La Vindication RX 6800 :Radeon RX 6800 de 16 Go
5. Tableau de bord architectural : Longévité d’Ampère vs. RDNA 2
La matrice technique suivante présente les architectures de bus mémoire, les capacités d’IA locales et la stabilité en jeu moderne pour les gammes de produits Ampere et RDNA 2 :
| Modèle de GPU | Silicium et bus | Pool de VRAM | Statut du LLM local (8B) | Durabilité des jeux en 1440p |
|---|---|---|---|---|
| GeForce RTX 3060 | GA106 | 192 bits | 12 Go | Fluide (38 t/s) : | Pas de flou de texture. FPS bruts plus bas, mais une cadence d’images parfaitement stable. |
| GeForce RTX 3060 Ti | GA104 | 256 bits | 8 Go | Goulets d’étranglement : | Débordement critique de la VRAM et micro-saccades dans les jeux modernes. |
| GeForce RTX 3070 / Ti | GA104 | 256 bits | 8 Go | CUDA OOM : | Un silicium performant paralysé par l’apparition soudaine de textures et par des pertes de 1 %. |
| GeForce RTX 3080 | GA102 | 320 bits | 10 Go | Borderline : | En difficulté avec le ray tracing en 4K ; avertissements fréquents de manque de mémoire. |
| GeForce RTX 3080 Ti | GA102 | 384 bits | 12 Go | Prise en charge : | Marge de sécurité suffisante pour les préréglages exigeants en 1440p/4K. |
| Radeon RX 6700 XT | Navi 22 | 192 bits | 12 Go | Prise en charge solide de ROCm ; les modèles 8B se chargent sans pression sur la mémoire. | Immunisé contre les goulots d’étranglement liés aux textures en jeu à 1440p et avec un taux de rafraîchissement élevé. |
| Radeon RX 6800 / XT | Navi 21 | 256 bits | 16 Go | Exceptionnel : | Impeccable : |
6. Conclusion : La plus grande ironie de l’histoire moderne des GPU
La GeForce RTX 3060 12 Go a consolidé son héritage en tant que carte devenue immortelle par accident. NVIDIA n’avait jamais eu l’intention de livrer une perle budgétaire pour l’IA ou une championne résistante au vieillissement ; les calculs mathématiques d’un bus à 192 bits ne leur laissaient tout simplement aucune alternative viable aux 12 Go.
À l’inverse, la décision calculée de confiner les RTX 3070 et 3070 Ti dans un bac à sable de 8 Go a précipité l’obsolescence de ces puces haut de gamme dans les moteurs de jeu modernes comme dans les flux de travail d’IA locaux. La génération Ampere constitue une leçon durable pour les assembleurs de PC : le nombre brut de cœurs et les fréquences de calcul ne signifient rien lorsqu’un tampon mémoire insuffisant empêche la puce de s’exprimer pleinement.
Foire aux questions
La RTX 3060 12 Go a-t-elle vraiment mieux résisté que la RTX 3070 8 Go ?
Dans la rasterisation brute, lorsque la VRAM n’est pas saturée, la 3070 reste plus rapide. Cependant, dans les jeux modernes dont la VRAM dépasse 8 Go, la 3070 subit de graves micro-saccades et des textures floues, tandis que la 3060 maintient un débit d’images stable. Dans les flux de travail d’IA locaux (Ollama/LLM), la 3060 12 Go surpasse complètement la 3070.
Pourquoi NVIDIA n’a-t-elle pas équipé la RTX 3070 de 16 Go ?
Il n’y avait aucune barrière technique. La station de travail professionnelle RTX A4000 utilisait exactement la même puce GPU GA104, dotée de 16 Go de mémoire. NVIDIA a délibérément maintenu la 3070 à 8 Go afin de protéger les ventes de la RTX 3080 de 10 Go et d’empêcher les configurations multi-GPU grand public bon marché de concurrencer ses accélérateurs d’IA d’entreprise très rentables.
Pourquoi 8 Go de VRAM sont-ils insuffisants pour les modèles linguistiques d’IA locaux ?
Un modèle de paramètres standard 8B en quantification 4 bits occupe environ 5 Go, mais l’activation d’une fenêtre de contexte de 8k tokens porte la consommation totale à 8,5–10 Go. Lorsque la mémoire déborde dans la RAM système, la latence élevée de PCIe réduit drastiquement les vitesses de génération, passant de 40 tokens/s à seulement 1 token/s.
Pourquoi l’épuisement de la VRAM provoque-t-il des saccades violentes plutôt qu’une simple baisse modérée du nombre d’images par seconde ?
La mémoire GDDR6 fonctionne avec une bande passante de 400 à 500 Go/s, tandis que le slot PCIe x16 de la carte mère atteint un maximum de 15 à 30 Go/s. Lorsque le GPU épuise sa VRAM locale et doit récupérer des données via PCIe depuis la RAM système, le processeur s’immobilise en attendant les ressources, ce qui provoque des pics soudains de plusieurs millisecondes dans le temps de rendu des images (effondrement du 1 % le plus bas).
Have thoughts, questions, or benchmarks on this topic? Join the discussion on our forums.
Join Discussion ➔


Rejoignez la conversation